Google-Gemini-Kosten sind keine einzelne Zahl. Die Gemini-App, Google AI Studio und die Gemini-API rechnen jeweils anders ab. Beginnen Sie mit Googles live Gemini-API-Preisseite und nutzen Sie dann diesen Leitfaden, um zu sehen, auf welchem Produkt Sie tatsächlich sind und welche Architektur-Entscheidungen die Rechnung bewegen.
Standard-API-Setups sind der teure Weg für dokumentlastige Arbeit: Jede Anfrage sendet denselben Kontext erneut und Sie zahlen jedes Mal Eingabe-Token. Kontext-Caching rechnet diesen wiederholten Präfix zu einem niedrigeren Satz ab. Deshalb treibt das Design, nicht der Headline-Preis pro Million Token, die Schlussrechnung.
Update (Oktober 2026): Gemini 3 Pro Preview ist in der Gemini API abgeschaltet. Der Nachfolger Gemini 3.1 Pro Preview hat dieselben Preise pro Token, daher verwenden die Pro-Zahlen und Rechenbeispiele unten diese Preise. Google hat inzwischen neuere Modelle ergänzt, darunter Gemini 4 Argon und Gemini 3.8 Flash, mit Einführungspreisen, die zu angekündigten Terminen steigen. Prüfen Sie die Preisseite für diese Modelle.
Google Gemini 3 API-Kosten: Was kostet die Nutzung wirklich?
Freie Ebene: Verfügbar für Tests und leichte Nutzung über Google AI Studio und die Gemini-App. Hat Ratenbeschränkungen und ist für die Produktion möglicherweise nicht ausreichend.
Pläne für Verbraucher: Google AI Pro (ca. $20/Monat) umfasst den Zugang zu Googles Pro-Modell in der Gemini-App. Google AI Ultra (ca. 250 $/Monat) umfasst Gemini 3 DeepThink für fortgeschrittenes logisches Denken.
API-Preise (Abrechnung nach Aufwand):
- Gemini 3 Flash: Etwa 0,25-0,50 $ pro Million Eingabe-Token, 1,50-3,00 $ pro Million Ausgabe-Token
- Gemini 3.1 Pro: Ungefähr $2-4 pro Million Input-Token, $12-18 pro Million Output-Token (variiert je nach Kontextlänge)
Unternehmen/Arbeitsbereich: Die Preise variieren je nach Tarif und Nutzerzahl. Kontaktieren Sie Google für individuelle Preise.
Quelle: Preise für Google AI Studio, Google One-Pläne
Realitätsprüfung: Die Preise ändern sich häufig. Überprüfen Sie stets die aktuellen Preise auf den offiziellen Preisseiten, bevor Sie Ihre Budgetentscheidungen treffen. Die oben genannten Zahlen wurden im Oktober 2026 mit Googles Preisseite abgeglichen und können je nach Region variieren.
Welches Gemini 3 Preismodell passt zu Ihrem Projekt?
Die Preise für Gemini 3 sind in vier Hauptkategorien unterteilt: kostenloses Tier, Abonnements für Verbraucher, API-Pay-as-you-go und Unternehmenspläne. Wenn Sie wissen, welche Stufe für Ihren Anwendungsfall geeignet ist, können Sie verhindern, dass Sie zu viel bezahlen oder an unerwartete Grenzen stoßen.
Kostenlose Ebene: Testen und leichte Nutzung
Die kostenlose Stufe bietet Ihnen Zugriff auf Gemini 3 über Google AI Studio und die Gemini-App ohne Abonnement. Sie ist für Experimente gedacht, nicht für die Produktion.
Was Sie bekommen:
- Zugang zu Gemini in der Web-App und mobil
- Grundtarifgrenzen (ausreichend für Tests und leichte Nutzung)
- Standard-Kontextfenster
- Keine Kreditkarte erforderlich
Beschränkungen:
- Ratenbeschränkungen können die Nutzung großer Mengen drosseln
- In Spitzenzeiten kann es zu langsameren Reaktionszeiten kommen.
- Eingeschränkter Zugang zu erweiterten Funktionen
- Nicht geeignet für Produktionsautomationen, die täglich Tausende von Anfragen verarbeiten
Wenn eine kostenlose Ebene ausreicht:
- Lernen des Modells und Testen von Aufforderungen
- Prototyping kleiner Arbeitsabläufe
- Einmalige Aufgaben und persönliche Projekte
- Geringes Nutzungsvolumen (unter 100 Anfragen pro Tag)
Wann ein Upgrade erforderlich ist:
- Produktionsautomatisierungen, die einen konsistenten Zugang benötigen
- Arbeitsabläufe mit hohem Volumen (mehr als 1.000 Anfragen pro Tag)
- Bedarf an garantierten Reaktionszeiten
- Unternehmensfunktionen wie Verwaltungskontrollen und Compliance
Pläne für Verbraucher: Google AI Pro und Ultra
Für die private Nutzung und kleine Teams bietet Google Abonnements an, die mit dem Google One-Speicher gebündelt sind.
Google AI Pro (ca. 20 $/Monat):
- Höhere Limits für Googles Pro-Modell in der Gemini-App
- Vorrangiger Zugang und schnellere Reaktionszeiten
- Längere Kontextfenster als bei der kostenlosen Variante
- Früher Zugang zu neuen Funktionen
- Enthält die Vorteile von Google One Storage
Google AI Ultra (ca. 250 $/Monat):
- Zugang zu Gemini 3 DeepThink (erweiterter Denkmodus)
- Alle Pro-Funktionen plus erweiterte Argumentationsmöglichkeiten
- Am besten geeignet für komplexe Analyse- und Forschungsaufgaben
- Inklusive Premium-Speicherplatz für Google One
Für wen diese Pläne geeignet sind:
- Einzelne Kreative und Fachleute
- Kleine Teams (1-5 Personen), die Gemini für Inhalte, Recherchen oder Analysen nutzen
- Nutzer, die vorhersehbare monatliche Kosten im Vergleich zum Umlageverfahren wünschen
- Teams, die keine Unternehmensfunktionen oder benutzerdefinierten Integrationen benötigen
Wenn API-Preise besser sind:
- Erstellung benutzerdefinierter Anwendungen oder Automatisierungen
- Notwendigkeit eines programmatischen Zugangs
- Variable Nutzung, die keine monatlichen Abonnements rechtfertigt
- Integration in bestehende Tools und Arbeitsabläufe
Quelle: Google One AI-Pläne
API-Preise: Pay-as-you-go für Entwickler
Wenn Sie Anwendungen oder Automatisierungen erstellen, ermöglicht Ihnen die API-Preisgestaltung einen programmatischen Zugang mit Kosten, die mit der Nutzung skalieren. Dies ist der Fall bei den meisten Automatisierungen für kleine Unternehmen.
Gemini 3 Flash Vorschau (Budgetstufe für einfache Aufgaben):
Standardverwendung:
- Eingabe: Ungefähr $0,50 pro Million Token (Text, Bild, Video), $1,00 pro Million Token (Audio)
- Ausgabe: Ungefähr $3,00 pro Million Token
- Kontext-Caching: Etwa 0,05 $ pro Million Token (Text, Bild, Video), 0,10 $ pro Million Token (Audio)
- Erdung mit Google Search: 5.000 Suchanfragen/Monat kostenlos, danach ca. $14 pro 1.000 Suchanfragen
Stapelverarbeitung:
- Input: Ungefähr 0,25 $ pro Million Token (Text, Bild, Video), 0,50 $ pro Million Token (Audio)
- Ausgabe: Ungefähr 1,50 $ pro Million Token
- Kontext-Caching: Wie bei Standard
- Erdung mit Google Search: 5.000 Anfragen/Monat kostenlos (gemeinsam für Gemini 3 und neuere Modelle), danach ca. $14 pro 1.000 Abfragen
Gemini 3.1 Pro Vorschau (Ausgewogene Leistung; Nachfolger von Gemini 3 Pro Preview):
Für Aufforderungen ≤200K Token:
- Einsatz: Ungefähr $2,00 pro Million Token
- Ausgabe: Ungefähr $12,00 pro Million Token
Für Eingabeaufforderungen >200K Token:
- Einsatz: Ungefähr $4,00 pro Million Token
- Ausgabe: Ungefähr $18,00 pro Million Token
Kontextfenster: 1.048.576 Eingabe-Token für Pro und Flash (Modellkarte Gemini 3 Flash)
Beste Anwendungsfälle:
- Blitzlicht: Einfache Aufgaben mit hohem Volumen, kostenempfindliche Anwendungen, Textverarbeitung
- Pro: Komplexe Argumentation, multimodale Aufgaben, Produktionsanwendungen, die erweiterte Fähigkeiten erfordern
Quelle: Google Gemini API-Preise
Wichtige Erkenntnis: Die Stapelverarbeitung kann die Flash-Kosten halbieren, erfordert aber eine Warteschlange für Anfragen und längere Latenzzeiten. Verwenden Sie Stapelverarbeitung für Nicht-Echtzeit-Workflows, bei denen die Kosten wichtiger sind als die Geschwindigkeit.
Unternehmens-/Arbeitsbereichspläne: Teams und Compliance
Für größere Unternehmen bietet Google Gemini über Workspace-Tarife mit Verwaltungskontrollen, Compliance-Funktionen und individuellen Preisen an.
Was die Unternehmenspläne beinhalten:
- Admin-Kontrollen und Benutzerverwaltung
- Funktionen für Data Governance und Compliance
- Integration mit Google Workspace (Docs, Sheets, Gmail)
- Individuelle Preisgestaltung auf der Grundlage von Nutzerzahl und Nutzung
- Support-SLAs und engagierter Support
Wer braucht Unternehmenspläne:
- Teams von 10+ Benutzern
- Organisationen mit Compliance-Anforderungen
- Unternehmen, die Verwaltungskontrollen und Prüfpfade benötigen
- Unternehmen, die individuelle Integrationen benötigen
Wenden Sie sich an den Google Workspace-Vertrieb, um individuelle Preise für die Anforderungen Ihres Unternehmens zu erhalten.
Welche Faktoren beeinflussen die Gemini 3 API-Preise am stärksten?
Ihre Gemini 3 Rechnung hängt von vier Hauptfaktoren ab. Wenn Sie verstehen, welche Faktoren sich auf Ihre spezifischen Arbeitsabläufe auswirken, können Sie Ihre Kosten effektiv optimieren.
Output-Token: Der größte Kostentreiber
Nach Googles aktuellen Preisen kostet ein Ausgabe-Token sechsmal so viel wie ein Eingabe-Token, bei Pro wie bei Flash. Wenn Ihre Arbeitsabläufe lange Antworten erzeugen, treibt dies den Großteil Ihrer Kosten.
Beispiel einer Kostenaufstellung:
- Eingabe: 10.000 Token zu $2/1M = $0,02
- Ausgabe: 5.000 Token zu $12/1M = $0,06
- Insgesamt: 0,08 $ (der Output ist 3x so hoch wie der Input, obwohl er nur die Hälfte der Token beträgt)
Was das bedeutet:
- Verdichtungsworkflows (kurze Ausgabe) kosten weniger als Generierungsworkflows (lange Ausgabe)
- Chatbots, die ausführliche Antworten generieren, kosten mehr als knappe Antworten
- Die Codegenerierung (lange Ausgaben) kann im Vergleich zur Klassifizierung (kurze Ausgaben) teuer sein.
Optimierungsstrategien:
- Verlangen Sie nach Möglichkeit kürzere Ausgaben ("in 3 Sätzen zusammenfassen" statt "zusammenfassen")
- Verwenden Sie Flash für einfache Aufgaben, die keine langen Antworten erfordern
- Zwischenspeichern von Antworten bei wiederholten Abfragen
- Festlegen von max_tokens-Grenzen zur Begrenzung der Ausgabelänge
Nutzung des Kontextfensters: Für nicht genutzte Kapazität bezahlen
Gemini 3 bietet ein Kontextfenster von 1 Million Token, aber Sie zahlen für die Token, die Sie senden, nicht für die verfügbare Kapazität. Größere Kontexte bedeuten jedoch mehr Eingabe-Token, was die Kosten erhöht.
Der Kompromiss:
- Kleiner Kontext (50K Token): Geringere Inputkosten, kann mehrere API-Aufrufe erfordern
- Großer Kontext (500K Token): Höhere Inputkosten, aber ein einziger Anruf verarbeitet alles
Wenn großer Zusammenhang Geld spart:
- Verarbeitung ganzer Dokumente in einem Aufruf vs. Chunking
- Beibehaltung langer Gesprächsverläufe ohne Zusammenfassung
- Analyse vollständiger Codebasen mit vollständigem Kontext
Wenn große Zusammenhänge Geld verschwenden:
- Versenden von 50K Token, wenn Sie nur 10K benötigen
- Einfügen von unnötigem Kontext in jede Anfrage
- Keine Verwendung des Kontext-Caching für wiederholte Basisinhalte
Profi-Tipp: Verwenden Sie das Kontext-Caching für Inhalte, die in mehreren Anfragen vorkommen (z. B. System-Prompts, Style Guides oder Basisdokumente). Zwischengespeicherte Eingabe-Token kosten bei Pro 0,20 $ pro Million statt 2,00 $, zuzüglich einer stündlichen Speichergebühr.
Multimodale Eingaben: Bilder, Video und Audio summieren sich
Gemini 3 verarbeitet Text, Bilder, Video und Audio. Multimodale Eingaben kosten mehr als reine Texteingaben.
Unterschiede in der Preisgestaltung:
- Text: Es gelten die Standardtarife
- Bilder: Zählt als Token (variiert je nach Auflösung)
- Video: Höhere Tokenanzahl, kann zusätzliche Verarbeitungskosten verursachen
- Audio: Höhere Raten ($1.00/1M Token für Flash, variiert für Pro)
Auswirkungen auf die Kosten:
- Bildlastige Arbeitsabläufe (Dokumentenanalyse, visuelle Inhalte) kosten mehr als reine Textabläufe
- Die Videoverarbeitung kann erheblich teurer sein
- Audiotranskription und -analyse erhöhen die Kosten
Optimierung:
- Komprimieren Sie Bilder vor dem Versand, wenn möglich
- Verwenden Sie Textbeschreibungen anstelle von Bildern, wenn dies ausreichend ist.
- Stapelverarbeitung multimodaler Anfragen zur Verringerung des Aufwands
- Überlegen Sie, ob Multimodalität für jeden Anwendungsfall notwendig ist.
Tarifgrenzen: Wenn gratis nicht gratis ist
Bei kostenlosen und kostengünstigeren Tarifen gibt es Tarifgrenzen, die Upgrades erzwingen können, selbst wenn die Kosten pro Token akzeptabel sind.
Häufige Szenarien für Preisobergrenzen:
- Kostenlose Stufe begrenzt Anfragen pro Stunde/Tag
- Niedrigere API-Stufen können während der Spitzenzeiten gedrosselt werden
- Workflows mit hohem Volumen stoßen an ihre Grenzen und erfordern Tier-Upgrades
Auswirkungen auf die Kosten:
- Das Erreichen von Tarifgrenzen erzwingt Upgrades auf höhere Stufen
- Drosselung in Spitzenzeiten verlangsamt Arbeitsabläufe
- Möglicherweise müssen Warteschlangen- oder Ausweichstrategien implementiert werden.
Lösungen:
- Testen Sie das erwartete Volumen gegen die Tarifgrenzen, bevor Sie sich festlegen.
- Implementierung einer Wiederholungslogik mit exponentiellem Backoff
- Stapelverarbeitung verwenden, um die Anzahl der Anfragen zu reduzieren
- Erwägen Sie hybride Ansätze (Flash für hohe Volumen, Pro für komplexe)
Wie skaliert die Gemini 3 Preisgestaltung bei hoher API-Auslastung?
Wenn Sie wissen, wie sich die Kosten entwickeln, können Sie Ihr Budget genau planen und Optimierungsmöglichkeiten erkennen. Hier finden Sie realistische Szenarien für verschiedene Nutzungsgrade.
Geringes Volumen: 100-1.000 Anfragen pro Monat
Szenario: Kleines Unternehmen, das Kunden-Support-Tickets bearbeitet oder Wochenberichte erstellt.
Annahmen:
- 5.000 Eingabe-Token pro Anfrage
- 2.000 Ausgabemarken pro Antrag
- Verwendung von Gemini 3.1 Pro (Standardpreis)
Monatliche Kosten:
- 100 Anfragen: ~1,00 $ Input + 2,40 $ Output = 3,40 $/Monat
- 1.000 Anfragen: ~10 $ Input + 24 $ Output = 34 $/Monat
Optimierungsmöglichkeiten:
- Die kostenlose Stufe kann für sehr geringe Mengen ausreichend sein
- Erwägen Sie Flash für einfache Aufgaben: Es kostet pro Token ein Viertel von Pro, diese Aufgaben werden also 75 % günstiger
- Zwischenspeichern von Antworten bei wiederholten Abfragen
Realitätsprüfung: Ein Verbraucher-Abonnement enthält keine API-Nutzung. Bei diesem Volumen bleibt die API-Rechnung klein: etwa 34 $ im Monat mit Pro für 1.000 Anfragen oder etwa 8,50 $ mit Flash.
Mittleres Volumen: 10.000-100.000 Anfragen pro Monat
Szenario: Wachsendes Unternehmen, das die Lead-Qualifizierung, Inhaltserstellung oder Datenverarbeitung automatisiert.
Annahmen:
- 10.000 Eingabe-Token pro Anfrage
- 3.000 Ausgabemarken pro Antrag
- Verwendung von Gemini 3.1 Pro (Standardpreis)
Monatliche Kosten:
- 10.000 Anfragen: ~200 $ Input + 360 $ Output = 560 $/Monat
- 100.000 Anfragen: ~2.000 $ Input + 3.600 $ Output = 5.600 $/Monat
Optimierungsmöglichkeiten:
- Alles auf Flash umstellen: 140-1.400 $/Monat (75 % Ersparnis)
- Verwenden Sie die Stapelverarbeitung für Nicht-Echtzeit-Workflows: weitere 50 % Rabatt auf die Flash-Preise
- Caching für wiederholte Abfragen implementieren: Zwischengespeicherte Antworten kosten bei erneuter Auslieferung nichts
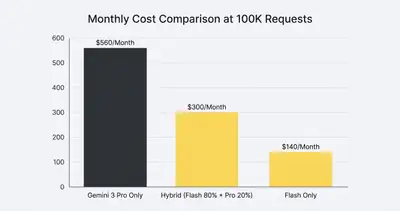
- Hybrider Ansatz (Flash für 80 %, Pro für 20 %): 224-2.240 $/Monat (60 % Ersparnis)
Hohes Volumen: 1 Mio. und mehr Anfragen pro Monat
Szenario: Unternehmensautomatisierung bei der Verarbeitung großer Datenmengen, bei der Erstellung von Inhalten oder bei Kundeninteraktionen.
Annahmen:
- 15.000 Eingabe-Token pro Anfrage
- 4.000 Ausgabemarken pro Antrag
- Mischung aus einfachen (80%) und komplexen (20%) Aufgaben
Monatliche Kosten (nur Pro):
- 1M Anfragen: ~ 30.000 $ Input + 48.000 $ Output = 78.000 $/Monat
Optimierungsstrategien:
- Hybrider Ansatz (Flash 80 %, Pro 20 %): ~15.600 $ Flash + 15.600 $ Pro = 31.200 $/Monat (60 % Ersparnis)
- Stapelverarbeitung für den Flash-Anteil: ~7.800 $ Flash + 15.600 $ Pro = 23.400 $/Monat (70 % Ersparnis)
- Kontext-Caching: senkt die Eingabeseite weiter, wie stark, hängt davon ab, wie viel von jedem Prompt sich wiederholt
Das Wichtigste zum Mitnehmen: Unter diesen Annahmen senken Routing und Stapelverarbeitung die Rechnung um 60-70 %. Ihr Ergebnis hängt davon ab, wie viele Ihrer Aufgaben Flash bewältigen kann.
Wichtige Erkenntnis: Die größten Kosteneinsparungen ergeben sich aus der Verwendung der richtigen Modellebene für jede Aufgabe. Die Beispiele oben gehen davon aus, dass Flash 80 % der Anfragen bewältigt. Testen Sie diesen Anteil mit Ihren eigenen Aufgaben, bevor Sie damit budgetieren.
Gemini 3 Kosten: Die größten Mythen im Faktencheck
Mehrere Missverständnisse können dazu führen, dass zu viel bezahlt wird oder das falsche Preismodell gewählt wird.
"Die kostenlose Stufe ist ausreichend für die Produktion"
Die Realität: Die kostenlose Stufe hat Ratenbeschränkungen und kann während der Spitzenzeiten gedrosselt werden. Für Produktionsautomatisierungen, die täglich Hunderte oder Tausende von Anfragen verarbeiten, benötigen Sie wahrscheinlich kostenpflichtige Pläne oder API-Preise.
Wenn Freiheit funktioniert:
- Erprobung und Prototyping
- Persönliche Projekte mit geringem Volumen
- Lernen und Experimentieren
Wann ein Upgrade erforderlich ist:
- Produktionsabläufe, die einen einheitlichen Zugriff erfordern
- Hoher Nutzungsumfang (mehr als 1.000 Anfragen pro Tag)
- Bedarf an garantierten Reaktionszeiten
- Unternehmensfunktionen oder Compliance-Anforderungen
"Die API-Preise sind die gleichen wie die der Verbraucher".
Die Realität: Die API-Preise sind nutzungsabhängig und skalieren mit der Nutzung. Verbraucherpläne sind Pauschalabonnements für Personen, die die Gemini-App nutzen. Ein Abonnement enthält keine API-Nutzung, daher konkurrieren beide nur dann, wenn eine Person in der App die Aufgabe statt einer Automatisierung erledigen könnte.
Entscheidungsrahmen:
- Berechnen Sie Ihre erwarteten API-Kosten auf der Grundlage der Nutzung
- Vergleich mit den Kosten eines Abonnements
- Berücksichtigen Sie gegebenenfalls andere Google One-Vorteile
- Testen Sie die tatsächliche Nutzung, bevor Sie sich langfristig binden.
"Ein größeres Kontextfenster spart immer Geld"
Die Realität: Sie zahlen für gesendete Token, nicht für die verfügbare Kapazität. Ein Kontextfenster mit 1 Mio. Token kostet nicht mehr als ein 128K-Fenster, wenn Sie nur 50K Token senden. Größere Kontexte können jedoch die Verarbeitung von Einzelaufrufen ermöglichen, was im Vergleich zu mehreren Aufrufen Geld spart.
Wenn großer Zusammenhang Geld spart:
- Verarbeitung ganzer Dokumente in einem Aufruf vs. Chunking
- Aufrechterhaltung langer Gesprächsverläufe
- Analyse vollständiger Codebasen mit vollständigem Kontext
Wenn große Zusammenhänge Geld verschwenden:
- Senden von unnötigem Kontext in jeder Anfrage
- Keine Verwendung von Kontext-Caching für wiederholte Inhalte
- Aufnahme irrelevanter Daten, die die Anzahl der Token erhöhen
Optimierung:
- Nur notwendigen Kontext einbeziehen
- Kontext-Caching für wiederholte Basisinhalte verwenden
- Gruppieren großer Dokumente, wenn die Verarbeitung in einem einzigen Aufruf nicht erforderlich ist
Gemini 3 Kosten optimieren: So sparen Sie bis zu 70 %
Mit diesen Strategien können die Kosten für Gemini 3 erheblich gesenkt werden, ohne dass die Leistungsfähigkeit für die meisten Arbeitsabläufe beeinträchtigt wird.
Strategie 1: Verwenden Sie für jede Aufgabe die richtige Modellebene
Der Ansatz: Verwenden Sie Gemini 3 Flash für einfache Aufgaben und Gemini 3.1 Pro nur für komplexe Argumentationen oder multimodale Aufgaben.
Auswirkungen auf die Kosten:
- Flash kostet bei Input und Output ein Viertel von Pro (0,50 $ statt 2,00 $ und 3,00 $ statt 12,00 $ pro Million Token)
- Aufgaben, die zu Flash wechseln, kosten 75 % weniger
- Pro weiterhin verfügbar für Aufgaben, die es benötigen
Umsetzung:
- Weiterleitung einfacher Abfragen (Klassifizierung, Extraktion, Basisgenerierung) an Flash
- Weiterleitung komplexer Abfragen (Argumentation, Analyse, multimodal) an Pro
- Verwenden Sie eine einfache Regel: "Wenn es keine fortgeschrittenen Überlegungen braucht, verwenden Sie Flash".
Strategie 2: Stapelverarbeitung für Nicht-Echtzeit-Workflows
Der Ansatz: Stellen Sie Anfragen in eine Warteschlange und bearbeiten Sie sie in Stapeln, um Stapelpreise zu erhalten (50 % Rabatt auf Flash).
Auswirkungen auf die Kosten:
- 50%ige Reduzierung der Flash-Input/Output-Kosten
- Am besten für Arbeitsabläufe, die keine sofortigen Antworten erfordern
Wann zu verwenden:
- Erstellung von Berichten
- Arbeitsplätze in der Datenverarbeitung
- Generierung von Inhalten, die in eine Warteschlange gestellt werden können
- Jeder Arbeitsablauf mit akzeptabler Latenzzeit (Minuten bis Stunden)
Abwägungen:
- Längere Latenzzeit (Anfragen werden in eine Warteschlange gestellt und gemeinsam verarbeitet)
- Kann Infrastruktur für Warteschlangen erfordern
- Nicht geeignet für Echtzeitanwendungen
Strategie 3: Zwischenspeichern von Antworten für wiederholte Abfragen
Der Ansatz: Speichern Sie Antworten für Abfragen, die wahrscheinlich wiederholt werden, und stellen Sie Ergebnisse aus dem Cache bereit, anstatt neue API-Aufrufe zu tätigen.
Auswirkungen auf die Kosten:
- Eine zwischengespeicherte Antwort kostet bei erneuter Auslieferung nichts
- Die Gesamtersparnis hängt davon ab, wie oft sich Abfragen wiederholen, messen Sie also Ihre Cache-Trefferquote
Wann zu verwenden:
- Häufig gestellte Fragen
- Wiederholte Datenabfragen
- Erzeugung statischer Inhalte
- Jedes Abfragemuster mit Wiederholungen
Umsetzung:
- Identifizieren Sie Abfragen, die sich wahrscheinlich wiederholen werden
- Implementierung einer Zwischenspeicherschicht (Redis, Datenbank oder dateibasiert)
- Festlegen eines angemessenen Cache-Ablaufs auf der Grundlage der erforderlichen Datenaktualität
- Überwachung der Cache-Trefferraten zur Messung der Wirksamkeit
Strategie 4: Optimierung der Promptlänge
Der Ansatz: Entfernen Sie unnötigen Kontext, verwenden Sie prägnante Aufforderungen und nutzen Sie die Zwischenspeicherung von Kontext für wiederholte Basisinhalte.
Auswirkungen auf die Kosten:
- Reduziert direkt die Kosten für den Einsatz von Token
- Kontext-Caching berechnet wiederholte Eingaben bei Pro mit 0,20 $ pro Million Token statt 2,00 $, zuzüglich Speicher
Optimierungsverfahren:
- Entfernen Sie irrelevanten Kontext aus Aufforderungen
- Verwenden Sie prägnante, gezielte Aufforderungen
- Nutzung von Kontext-Caching für Systemaufforderungen, Style Guides oder Basisdokumente
- Gruppieren großer Dokumente, wenn kein vollständiger Kontext erforderlich ist
Strategie 5: Festlegung von Grenzwerten für die Ausgabelänge
Der Ansatz: Verwenden Sie den Parameter max_tokens, um die Länge der Ausgabe zu begrenzen und unnötig lange Antworten zu vermeiden.
Auswirkungen auf die Kosten:
- Reduziert die Kosten für Output-Token (der größte Kostenfaktor)
- Jedes eingesparte Ausgabe-Token spart sechsmal so viel wie ein Eingabe-Token
Umsetzung:
- max_tokens auf der Grundlage des tatsächlichen Bedarfs festlegen
- Testen Sie verschiedene Grenzwerte, um das optimale Gleichgewicht zu finden
- Verwenden Sie kürzere Grenzwerte für einfache Aufgaben, längere für komplexe Analysen
- Überwachung der Ausgabequalität, um sicherzustellen, dass Grenzwerte die Ergebnisse nicht beeinträchtigen
Strategie 6: Hybrider Ansatz: Flash + Pro
Der Ansatz: Verwenden Sie Flash für einfache Abfragen und Pro für komplexe Schlussfolgerungen oder multimodale Aufgaben. Das Beispiel unten geht von einer Aufteilung 80/20 aus.
Auswirkungen auf die Kosten:
- Bei einer Aufteilung 80/20 etwa 60 % günstiger als nur Pro
- Behält die Fähigkeit für komplexe Aufgaben bei
- Das Beste aus beiden Welten: Kosteneffizienz + erweiterte Funktionen
Beispiel für Einsparungen:
- Nur Pro (100K Anfragen): ~5.600 $/Monat
- Hybrid (80K Flash + 20K Pro): ~2.240 $/Monat (60 % Ersparnis)
- Hybrid + Stapelverarbeitung für den Flash-Anteil: ~1.680 $/Monat (70 % Ersparnis)
Wann lohnt sich Gemini 3 für Unternehmen? Die besten Use-Cases
Die Preisgestaltung von Gemini 3 ist am sinnvollsten für bestimmte Anwendungsfälle, bei denen die Stärken mit Ihren Anforderungen übereinstimmen.
Multimodale Arbeitslasten (Bilder, Video, Audio)
Warum Gemini 3 gewinnt:
- Native multimodale Verarbeitung in einem einzigen Modell
- Wettbewerbsfähige Preise für multimodale Vorleistungen
- Keine Notwendigkeit für separate Bild-/Videobearbeitungsdienste
Kostenvergleich:
- Gemini 3 verarbeitet Text + Bilder in einem Anruf
- Alternativen können separate API-Aufrufe für jede Modalität erfordern
- Kann Komplexität und Latenz im Vergleich zu Multi-Service-Ansätzen verringern
Geeignet für:
- Dokumentenanalyse mit Bildern
- Analyse des Videoinhalts
- Audiotranskription und -analyse
- Inhaltserstellung mit gemischten Medien
Großer Kontextbedarf (1 Mio. Token)
Warum Gemini 3 gewinnt:
- Eingabefenster mit 1.048.576 Token bei Pro und Flash
- Wettbewerbsfähige Preise auch bei großen Kontexten
- Verarbeitung ganzer Codebasen oder langer Dokumente in einem einzigen Aufruf
Kostenvergleich:
- Kann Chunking und mehrere API-Aufrufe erfordern
- Der große Kontext von Gemini 3 kann die Anzahl der API-Aufrufe reduzieren
Geeignet für:
- Codebase-Analyse
- Verarbeitung langer Dokumente
- Ausführliche Gesprächshistorien
- Intelligente Plattformen für Dokumente
Integration des Google-Ökosystems
Warum Gemini 3 gewinnt:
- Native Integration mit Google Workspace (Docs, Sheets, Gmail)
- Nahtlose Authentifizierung und Zugang
- Keine zusätzlichen Integrationskosten
Kostenvergleich:
- Alternativen erfordern möglicherweise benutzerdefinierte Integrationen
- Zusätzliche Kosten für Middleware oder API-Gateway
- Komplexere Einrichtung und Wartung
Geeignet für:
- Teams, die bereits Google Workspace verwenden
- Arbeitsabläufe, die mit Google-Diensten integriert werden
- Organisationen mit Google Cloud-Infrastruktur
Einfache Aufgaben mit hohem Aufkommen
Warum Gemini 3 Flash gewinnt:
- Sehr wettbewerbsfähige Preise für einfache Aufgaben ($0,25-0,50/1M Input, $1,50-3,00/1M Output)
- Stapelverarbeitung bietet 50% zusätzlichen Rabatt
- Effiziente Handhabung hoher Volumen
Kostenvergleich:
- Flash ist für einfache Aufgaben oft billiger als Alternativen
- Stapelverarbeitung macht es noch kostengünstiger
- Gute Eignung für Klassifizierung, Extraktion, Basisgenerierung
Geeignet für:
- Verarbeitung großer Textmengen
- Einfache Klassifizierung und Extraktion
- Kostensensitive Anwendungen
- Nicht-Echtzeit-Batch-Workflows
Ist Gemini 3 die richtige Wahl für Ihr IT-Budget?
Die Preisgestaltung von Gemini 3 bietet Flexibilität in den Stufen kostenlos, Privatkunden, API und Unternehmen. Die richtige Wahl hängt von Ihrem Nutzungsverhalten, Ihrem Volumen und Ihren spezifischen Anforderungen ab.
Die wichtigsten Erkenntnisse:
- Output-Token verursachen die meisten Kosten - Antwortlänge optimieren
- Verwenden Sie Flash für einfache Aufgaben, Pro für komplexe Überlegungen
- Stapelverarbeitung halbiert die Flash-Preise, und zwischengespeicherte Eingaben kosten bei Pro 90 % weniger
- Große Kontextfenster sparen nur Geld, wenn man sie effektiv nutzt
- Testen Sie die tatsächliche Nutzung, bevor Sie sich auf langfristige Pläne festlegen
Detaillierte Berechnungen der Token-Kosten finden Sie in unserem Kostenrechner für AI-Token. Zum Vergleich mit anderen Modellen, siehe Gemini 3 vs. OpenAI: Kosten, Grenzen und Kompromisse.
Wenn Sie Automatisierungen erstellen und Hilfe bei der Optimierung der Gemini 3 Kosten benötigen, Kontaktieren Sie uns um zu besprechen, wie wir Ihnen helfen können, die richtige Preisstufe zu wählen und Strategien zur Kostenkontrolle zu implementieren, die mit Ihrem Unternehmen wachsen.