Ihre Automatisierungsrechnung wächst stetig. Sie verarbeiten Millionen Token im Monat und sind sich nicht sicher, ob ein Modellwechsel die Kosten senken oder Ihre Arbeitsabläufe unterbrechen würde.
Dies ist keine theoretische Frage. Der Unterschied zwischen Google Gemini 3 und den aktuellen Modellen von OpenAI kann eine niedrigere oder eine höhere Rechnung bedeuten, je nach Ihren Arbeitslastmustern. Noch wichtiger: Die falsche Wahl kann bedeuten, dass Sie zu Spitzenzeiten an Ratenlimits stoßen, dass Kontextfenster Ihre Daten abschneiden oder dass Zuverlässigkeitsprobleme Sie Kunden kosten.
Schnell gewinnen: Der größte Kostentreiber ist nicht der Preis pro Token, sondern die ausgegebenen Token. Gemini 3 Flash berechnet 3,00 $ pro 1M Output-Token, ein Viertel der 12,00 $ von Gemini 3 Pro und weniger als ein Viertel der 14,00 $ von GPT-5.2.
Dieser Vergleich konzentriert sich auf das, was für die Produktion wichtig ist: Preisstrukturen, die sich tatsächlich auf Ihre Rechnung auswirken, Kontextlimits, die bestimmen, was Sie verarbeiten können, Ratenlimits, die Ihre Automatisierungen drosseln, und die praktischen Kompromisse, die bestimmen, welche Plattform zu Ihrem Stack passt.
Gemini vs. OpenAI: Die wahren Kostentreiber verstehen
Bevor Sie bestimmte Modelle vergleichen, sollten Sie sich darüber klar werden, was Ihre API-Rechnung antreibt:
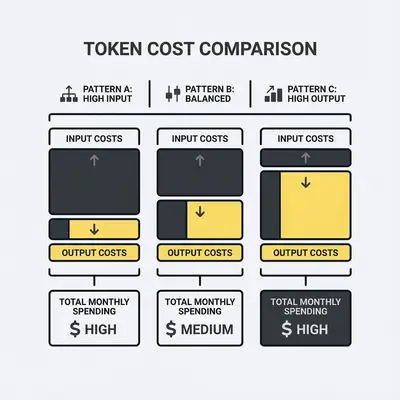
Eingabe- vs. Ausgabe-Token: Bei den meisten Modellen werden Input (was Sie senden) und Output (was Sie zurückbekommen) getrennt berechnet. Output ist teurer: das Vierfache bei GPT-4o und GPT-4o Mini, das Sechsfache bei Gemini 3 und das Achtfache bei GPT-5.2.
Kontextlänge: Längere Kontextfenster ermöglichen es Ihnen, mehr Daten in einem Aufruf zu verarbeiten. Sie zahlen für die gesendeten Token, ein 1M-Token-Fenster kostet also nichts extra, wenn Sie nur 50K Token senden.
Ratenobergrenzen: Kostenlose und kostengünstigere Modelle haben oft strengere Ratenbeschränkungen. Wenn Sie 10.000 Anfragen pro Stunde bearbeiten müssen, zwingt Sie ein billigeres Modell mit einer Obergrenze von 1.000 Anfragen pro Stunde zu einem Upgrade.
Gestaffelte Preisgestaltung: Beide Plattformen bieten mehrere Ebenen an. Wer für jede Aufgabe die richtige Stufe nutzt (einfache Abfragen → Budget-Stufe, komplexe Argumentation → Premium-Stufe), zahlt Premium-Preise nur für die Anfragen, die sie brauchen.
Preisvergleich: Gemini und OpenAI Kosten im Detail
Google Gemini 3 Preisstruktur
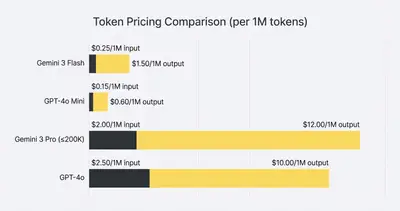
Gemini 3 Flash Vorschau (Budgetstufe für einfache Aufgaben):
- Einsatz: 0,50 $ pro 1 Million Token
- Ausgabe: 3,00 $ pro 1 Million Token
- Kontext-Fenster: 1 Million Token
- Am besten geeignet für: Einfache Aufgaben mit hohem Volumen, kostenempfindliche Anwendungen
Gemini 3 Pro Vorschau (Ausgewogene Leistung):
- Input: $2,00 pro 1 Million Token (Eingabeaufforderungen ≤200K Token), $4,00 pro 1 Million Token (Eingabeaufforderungen >200K Token)
- Ausgabe: $12,00 pro 1 Million Token (Eingabeaufforderungen ≤200K Token), $18,00 pro 1 Million Token (Eingabeaufforderungen >200K Token)
- Kontext-Fenster: 1 Million Token
- Am besten geeignet für: Komplexe Argumentation, multimodale Aufgaben, Produktionsanwendungen
Quelle: Google Gemini API-Preise
OpenAI-Modell Preisstruktur
Die Preise von OpenAI variieren je nach Modellstufe. Die aktuellen Modelle umfassen:
GPT-4o Mini (Kostengünstige Stufe):
- Einsatz: Ungefähr $0,15 pro 1 Million Token
- Ausgabe: Ungefähr $0,60 pro 1 Million Token
- Kontext-Fenster: 128K Token
- Am besten geeignet für: Einfache Aufgaben, hochvolumige Anwendungen
GPT-4o (Ausgewogene Leistung):
- Einsatz: Ungefähr 2,50 $ pro 1 Million Token
- Ausgabe: Ungefähr $10,00 pro 1 Million Token
- Kontext-Fenster: 128K Token
- Am besten geeignet für: Allzweckaufgaben, multimodale Anwendungen
GPT-5.2 (Premium-Stufe):
- Einsatz: 1,75 $ pro 1 Million Token
- Ausgabe: 14,00 $ pro 1 Million Token
- Kontext-Fenster: 400.000 Token
- Am besten geeignet für: Komplexe Argumentation, Codierungsaufgaben, maximale Leistungsfähigkeit
Quelle: OpenAI API-Preise
Realitätsprüfung: Die offiziellen Preise ändern sich häufig. Überprüfen Sie immer die aktuellen Preise auf den offiziellen Preisseiten, bevor Sie Ihre Budgetentscheidungen treffen. Die obigen Zahlen spiegeln den Stand der Preise im Dezember 2025 wider.
Kontextfenster-Grenzen: Token-Limits bei Gemini und OpenAI
Die Größe des Kontextfensters bestimmt, wie viele Daten Sie mit einem einzigen API-Aufruf verarbeiten können. Dies wirkt sich sowohl auf die Leistungsfähigkeit als auch auf die Kosten aus.
Zwillinge 3: 1 Million Token über alle Stufen hinweg
- Kann ganze Codebasen, Bücher in voller Länge oder umfangreiche Gesprächsverläufe verarbeiten
- Ermöglicht die Analyse der gesamten Repository-Historie
- Nützlich für Document-Intelligence-Plattformen, die große Sammlungen verarbeiten
OpenAI-Modelle: Abhängig vom Modell
- GPT-4o: 128K Token
- GPT-5.2: 400.000 Token (Modellseite)
- Ausreichend für die meisten Aufgaben der Geschäftsautomatisierung
- Kann bei sehr langen Dokumenten eine Bündelung erfordern
Wichtige Erkenntnis: Ein größeres Kontextfenster bedeutet nicht automatisch einen höheren Wert. Wenn Sie 50.000 Token-Dokumente verarbeiten, bringt eine Kapazität von 1 Mio. Token zusätzliche Kosten ohne Nutzen. Wählen Sie auf der Grundlage Ihres tatsächlichen Anwendungsfalls, nicht der maximalen Kapazität.
Wenn 1 Mio. Token wichtig sind:
- Analyse ganzer Codebasen mit vollständigem Kontext
- Bearbeitung vollständiger Dokumente in Buchform mit detaillierten Abfragen
- Führen von umfangreichen Gesprächsverläufen ohne Zusammenfassung
- Document Intelligence-Plattformen, die große Sammlungen aufnehmen
Wenn 128K-400K ausreichend sind:
- Die meisten Arbeitsabläufe der Geschäftsautomatisierung
- Analyse von Kunden-Support-Tickets
- E-Mail-Verarbeitung und Antwortgenerierung
- Standarddokumentenanalyse und -zusammenfassung
API-Ratenbegrenzungen: Grenzen für Ihre Gemini & OpenAI Skalierung
Ratenbeschränkungen bestimmen, wie viele Anfragen Sie pro Minute, Stunde oder Tag stellen können. Sie sind oft der Engpass, der Sie dazu zwingt, eine höhere Stufe zu wählen oder die Plattform zu wechseln.
Gemini 3 Rate Limits:
- Freie Ebene: Großzügige Grenzen für Entwicklung und Tests
- Pay-as-you-go: Höhere Grenzwerte für Produktionseinsätze
- Die spezifischen Grenzen variieren je nach Stufe und können sich ändern.
OpenAI-Rate-Grenzen:
- Variiert je nach Modell, Stufe und Kontotyp
- Freie Ebene: Untere Grenzen für Experimente
- Bezahlte Stufen: Höhere Grenzwerte, mit Optionen für spezielle Kapazitäten
- Grenzwerte können durch Unternehmensvereinbarungen erhöht werden
Profi-Tipp: Testen Sie Ihr erwartetes Anfragevolumen auf beiden Plattformen, bevor Sie sich festlegen. Ratenbeschränkungen können sich ändern, und das Überschreiten von Grenzen während der Spitzenzeiten kann Produktionsabläufe unterbrechen. Bauen Sie eine Wiederholungslogik und Fallback-Strategien ein.
Auswirkungen auf die Automatisierung:
- Workflows mit hohem Volumen (mehr als 10.000 Anfragen/Tag) können an die Grenzen der kostenlosen Stufe stoßen
- Stapelverarbeitung kann helfen, Ratenbeschränkungen zu umgehen
- Unternehmensvereinbarungen können dedizierte Kapazitäten bereitstellen
- Berücksichtigen Sie bei der Wahl zwischen Budget- und Prämienstufen Tarifgrenzen
Multimodale Fähigkeiten: Gemini und OpenAI im Vergleich
Beide Plattformen unterstützen multimodale Eingaben, allerdings mit unterschiedlichen Stärken.
Zwillinge 3:
- Native multimodale Verarbeitung: Text, Bilder, Audio, Video in einem einzigen Kontext
- Keine separaten Modellaufrufe für verschiedene Medientypen erforderlich
- Integrierte Verarbeitung über alle Medientypen hinweg
- Am besten geeignet für: Anwendungen, die eine Analyse verschiedener Medien erfordern
OpenAI:
- Starke Bild- und Audioverarbeitung
- Videoerstellung durch separate Sora-App
- Möglicherweise sind separate API-Aufrufe für verschiedene Medientypen erforderlich
- Am besten geeignet für: Textorientierte Anwendungen mit gelegentlichem Bild-/Audio-Bedarf
Beispiel: Ein Inhaltsmoderationssystem, das Benutzer-Uploads (Text, Bilder, Video) analysiert, profitiert von der nativen multimodalen Verarbeitung von Gemini 3. Ein Chatbot für den Kundensupport, der hauptsächlich Text verarbeitet und gelegentlich Bilder analysiert, könnte den Ansatz von OpenAI als ausreichend empfinden.
Plattformintegration: Vendor Lock-In bei Gemini & OpenAI vermeiden
Zwillinge 3:
- Tiefe Integration mit Google Cloud Platform (GCP)
- Nahtlose Integration mit Google Workspace, Gmail, Docs, Drive
- Erfordert möglicherweise eine GCP-Infrastruktur für optimale Leistung
- Potenzielle Anbieterbindung beim Aufbau einer umfangreichen GCP-abhängigen Infrastruktur
OpenAI:
- Flexiblere Optionen für Cloud-Anbieter
- Funktioniert über AWS, Azure, GCP und andere Plattformen
- Weniger plattformspezifische Infrastruktur erforderlich
- Leichtere Aufrechterhaltung einer Multi-Cloud-Strategie
Realitätsprüfung: Die Bindung an einen bestimmten Anbieter ist nicht per se schlecht - sie bietet oft eine bessere Leistung und Integration. Aber sie schränkt die Flexibilität ein. Wenn Sie bereits mit GCP arbeiten, ist die Integration von Gemini 3 eine Stärke. Wenn Sie AWS nutzen oder Multi-Cloud bevorzugen, bietet OpenAI mehr Flexibilität.
Beispielkosten: Gemini & OpenAI für KMU
Szenario 1: Kundensupport Triage (hohes Volumen, einfache Aufgaben)
Arbeitsbelastung: 5.000 Support-Tickets pro Monat, durchschnittlich 2.000 Input-Tokens, 500 Output-Tokens pro Ticket
Gemini 3 Flash:
- Eingabe: (5.000 × 2.000) / 1.000.000 × 0,50 $ = 5,00 $
- Ausgabe: (5.000 × 500) / 1.000.000 × 3,00 $ = 7,50 $
- Insgesamt: 12,50 $/Monat
GPT-4o Mini:
- Eingabe: (5.000 × 2.000) / 1.000.000 × $0,15 = $1,50
- Ausgabe: (5,000 × 500) / 1,000,000 × $0.60 = $1.50
- Gesamt: $3,00/Monat
Gewinner für dieses Szenario: GPT-4o Mini (geringere Kosten, ausreichende Leistungsfähigkeit)
Szenario 2: Document Intelligence Platform (langer Kontext, komplexe Analyse)
Arbeitsbelastung: 500 Dokumente pro Monat, durchschnittlich 150.000 Input-Tokens, 5.000 Output-Tokens pro Dokument
Gemini 3 Pro (≤200K Stufe):
- Eingabe: (500 × 150.000) / 1.000.000 × $2,00 = $150,00
- Ausgabe: (500 × 5,000) / 1,000,000 × $12.00 = $30.00
- Gesamt: $180.00/Monat
GPT-5.2 (400K Kontext):
- Eingabe: (500 × 150.000) / 1.000.000 × 1,75 $ = 131,25 $
- Ausgabe: (500 × 5,000) / 1,000,000 × $12.00 = $30.00
- Gesamt: 166,25 $/Monat
Gewinner für dieses Szenario: GPT-5.2 beim Preis (13,75 $/Monat weniger). Beide Fenster fassen ein Dokument mit 150K Token, testen Sie also die Ausgabequalität, bevor Sie wechseln.
Szenario 3: Vertriebsautomatisierung (gemischte Komplexität, Routing-Strategie)
Arbeitsbelastung: 2.000 Leads pro Monat
- 1.500 einfache Leads (1.000 Eingabe-, 200 Ausgabe-Token) → Haushaltsebene
- 500 komplexe Leads (5.000 Input-, 2.000 Output-Token) → Premium-Tier
Hybrid-Ansatz (Gemini 3 Flash + Gemini 3 Pro):
- Einfach: (1.500 × 1.000) / 1.000.000 × 0,50 $ + (1.500 × 200) / 1.000.000 × 3,00 $ = 0,75 $ + 0,90 $ = 1,65 $
- Komplex: (500 × 5.000) / 1.000.000 × $2,00 + (500 × 2.000) / 1.000.000 × $12,00 = $5,00 + $12,00 = $17,00
- Gesamt: 18,65 $/Monat
Einfaches Premium-Modell (GPT-4o für alle):
- Eingabe: (1.500 × 1.000 + 500 × 5.000) / 1.000.000 × 2,50 $ = 10,00 $
- Ausgabe: (1.500 × 200 + 500 × 2.000) / 1.000.000 × 10,00 $ = 13,00 $
- Insgesamt: 23,00 $/Monat
Gewinner für dieses Szenario: Hybrid-Routing mit Gemini 3 (19 % Kosteneinsparung)
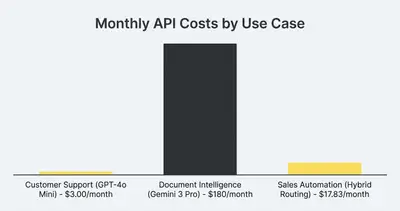
Profi-Tipp: Die meisten Produktionssysteme profitieren von intelligentem Routing. Verwenden Sie Budget-Tiers (Gemini 3 Flash, GPT-4o Mini) für einfache Abfragen, und reservieren Sie Premium-Tiers für komplexe Schlussfolgerungen. Szenario 3 zeigt, dass die Ersparnis davon abhängt, wie viel Ihres Volumens einfach ist.
Modellvergleich in der Praxis: Gemini und OpenAI testen
Bevor Sie sich auf eine Plattform festlegen, sollten Sie beide mit Ihren tatsächlichen Arbeitsabläufen testen. Hier ist eine einfache Methode:
Schritt 1: Erstellen einer Testsuite
- Sammeln Sie 20-50 reale Beispiele aus Ihrem Arbeitsablauf
- Einbeziehung von Sonderfällen: lange Eingaben, komplexe Argumentation, multimodale Inhalte
- Dokumentieren Sie die erwarteten Ergebnisse oder Erfolgskriterien
Schritt 2: Parallele Tests durchführen
- Testen Sie beide Plattformen mit identischen Prompts
- Aufzeichnung: Genauigkeit, Latenzzeit, Kosten pro Anfrage, Fehlerraten
- Testen Sie zu verschiedenen Zeiten (Modelle können Leistungsunterschiede aufweisen)
Schritt 3: Messen, was wichtig ist
- Genauigkeit: Entspricht der Output Ihren Qualitätsansprüchen?
- Latenzzeit: Ist die Antwortzeit für Ihren Anwendungsfall akzeptabel?
- Kosten: Berechnung der tatsächlichen Kosten pro Anfrage (nicht nur pro Token)
- Verlässlichkeit: Sehen Sie ein einheitliches Verhalten bei Wiederholungsversuchen?
Schritt 4: Test unter Last
- Simulieren Sie Ihr erwartetes Produktionsvolumen
- Prüfen Sie Ratengrenzen, Fehlerbehandlung und Rückfallverhalten
- Messen Sie die Kosten bei der Skalierung (die Preise können sich je nach Volumen ändern)
Schritt 5: Regelmäßige Wiederholungsprüfungen
- Modelle und Preise ändern sich im Laufe der Zeit
- Wiederholung von Tests beim Upgrade von Modellversionen
- Überwachung auf Verhaltensabweichungen oder Leistungsrückgänge
Wichtige Erkenntnis: Ein Modell, das in der Testphase perfekt funktioniert, kann in der Produktion versagen, wenn Sie die Ratenbegrenzung, die Kosten bei der Skalierung oder die Zuverlässigkeit unter Last nicht berücksichtigen. Testen Sie den gesamten Stack, nicht nur das Modell.
Entscheidungsrahmen: Wann Sie Gemini oder OpenAI wählen sollten
Wählen Sie Gemini 3, wenn:
- Sie müssen sehr lange Dokumente verarbeiten (1M-Token-Kontext)
- Ihre Anwendung erfordert eine native multimodale Verarbeitung (Text, Bilder, Audio, Video)
- Sie arbeiten bereits mit Google Cloud Platform oder Google Workspace
- Kosteneffizienz ist ein Hauptanliegen (Flash Tier ist sehr wettbewerbsfähig)
- Sie entwickeln Tools für die Analyse von Dokumenten oder der Codebase
Wählen Sie OpenAI, wenn:
- Sie brauchen ein Höchstmaß an Denkvermögen für komplexe Aufgaben
- Sie bevorzugen Flexibilität bei verschiedenen Cloud-Anbietern (AWS, Azure, GCP)
- Sie entwickeln Codierwerkzeuge oder Automatisierungslösungen, die eine starke Codegenerierung erfordern
- Sie brauchen bewährte Zuverlässigkeit und ein großes Ökosystem von Integrationen
- Ihr Anwendungsfall erfordert keine 1M-Token-Kontextfenster
Verwenden Sie beides (Hybridansatz), wenn:
- Sie haben eine gemischte Arbeitsbelastung (einfache + komplexe Aufgaben)
- Kostenoptimierung ist von entscheidender Bedeutung (einfache Abfragen an Budgetebenen weiterleiten)
- Sie möchten die Bindung an einen bestimmten Anbieter vermeiden
- Sie experimentieren und möchten die Leistung im Laufe der Zeit vergleichen
Realitätsprüfung: Viele erfolgreiche Produktionssysteme nutzen beide Plattformen. Ein intelligentes Routing, bei dem einfache Abfragen an Budget-Tiers und komplexe Schlussfolgerungen an Premium-Tiers gesendet werden, kann sowohl Kosten als auch Leistungsfähigkeit optimieren.
Ihr Aktionsplan: Nächste Schritte für Ihre AI-Strategie
Wenn Sie Modelle für ein neues Projekt evaluieren oder Ihre aktuelle Wahl überdenken wollen:
Tag 1-2: Sammeln Sie Ihre Daten
- Dokumentieren Sie Ihre aktuelle oder erwartete Arbeitsbelastung (Anfragen/Tag, durchschnittliche Token pro Anfrage)
- Identifizieren Sie Ihre Anwendungsfallmuster (einfach vs. komplex, rein textbasiert vs. multimodal)
- Berechnen Sie die aktuellen Kosten, wenn Sie bereits eine Plattform nutzen
Tag 3-4: Parallele Tests durchführen
- Testkonten auf beiden Plattformen einrichten
- Führen Sie Ihre Testsuite aus (20-50 echte Beispiele)
- Messung von Genauigkeit, Latenz und Kosten pro Anfrage
Tag 5: Die Entscheidung treffen
- Vergleichen Sie die Ergebnisse mit Ihren Prioritäten (Kosten, Leistungsfähigkeit, Zuverlässigkeit)
- Erwägen Sie hybrides Routing, wenn Sie gemischte Arbeitslasten haben
- Dokumentieren Sie Ihre Entscheidungskriterien für die Zukunft
Laufend: Überwachen und Optimieren
- Verfolgung der tatsächlichen Kosten gegenüber den Prognosen
- Überwachung auf Ratenbegrenzungsprobleme oder Probleme mit der Zuverlässigkeit
- Erneuter Test, wenn sich die Modellversionen ändern oder die Preise aktualisiert werden
Wenn Sie wissen möchten, welches Modell für Ihre spezifischen Automatisierungsanforderungen geeignet ist, können wir in weniger als 30 Minuten eine Kostenanalyse und einen Testvergleich durchführen. Buchen Sie ein kostenloses Automatisierungsaudit.
Fazit: Die beste Passform – Kein Universalsieger bei Gemini vs. OpenAI
Es gibt nicht das eine "beste" Modell. Die richtige Wahl hängt von Ihren Arbeitslastmustern, Kostenbeschränkungen und technischen Anforderungen ab.
Wichtigste Erkenntnisse:
- Output-Token treiben die Kosten: Wenn Sie lange Antworten generieren, berechnen Budget-Tiers (Gemini 3 Flash, GPT-4o Mini) ein Viertel oder weniger der Premium-Output-Preise
- Kontextfenster sind für bestimmte Anwendungsfälle wichtig: 1 Mio. Token ermöglichen die Analyse ganzer Codebasen, aber viele Geschäftsautomatisierungen bleiben deutlich unter 128K
- Hybrides Routing optimiert die Kosten und die Leistungsfähigkeit: Budget-Tiers für einfache Abfragen und Premium-Tiers für komplexe Fragestellungen senken die Rechnung, wie stark, hängt von Ihrem Mix ab
- Testen Sie, bevor Sie sich festlegen: Führen Sie parallele Tests mit Ihren tatsächlichen Arbeitsabläufen durch - Preisgestaltung und Leistung können je nach Anwendungsfall erheblich variieren.
Die KI-Modelllandschaft ändert sich schnell. Was heute optimal ist, kann sich in 6-12 Monaten ändern, wenn beide Plattformen Updates veröffentlichen und die Preise anpassen. Der zuverlässigste Ansatz besteht darin, Ihre Systeme so zu gestalten, dass sie flexibel sind, regelmäßig zu testen und anhand der tatsächlichen Produktionsdaten zu optimieren.
Sind Sie bereit, Ihre AI-Automatisierungskosten zu optimieren? Buchen Sie eine kostenlose Beratung um personalisierte Modellempfehlungen und Kostenprognosen für Ihren speziellen Anwendungsfall zu erhalten.
Über den Autor
Kevin Michael Schindler ist KI-Automatisierungsexperte bei Evalics und hilft kleinen Unternehmen bei der Implementierung praktischer Automatisierungssysteme, die Zeit sparen und Betriebskosten senken.