Ihre AI-Automatisierungsrechnung ist eingetroffen. Sie haben 500 Dollar erwartet. Sie bekamen 2.300 $.
Der Unterschied liegt nicht in einem Abrechnungsfehler, sondern in den versteckten Kostenmechanismen, die die meisten Teams nicht verstehen, bis die Rechnung eintrifft. Kontextfenster, die "kostenlos" zu sein scheinen, weil man nicht an Grenzen stößt. Wiederholungen, die die Kosten unbemerkt vervielfachen. Output-Tokens, die 5-10 mal mehr kosten als Input-Tokens. Lange Prompts, die jede Anfrage aufblähen.
Wenn Sie verstehen, wie Token-Limits und Kontextgröße die Kosten beeinflussen, geht es nicht nur um Budgetierung, sondern auch darum, die Automatisierung im großen Maßstab nachhaltig zu gestalten. Dieser Leitfaden schlüsselt die Kostenmechanismen auf, die Teams überraschen, mit durchgerechneten Szenarien und Optimierungsstrategien, die Ihre KI-Ausgaben senken.
Schnell gewinnen: Die größten Kostentreiber sind Ausgabe-Token und Kontext, den Sie senden, aber nicht brauchen. Wer die Ausgabelänge begrenzt und Prompts kürzt, senkt die Rechnung bei jedem Aufruf.
Wie Kontextfenster Kosten verursachen
Kontextfenster bestimmen, wie viele Daten Sie mit einem einzigen API-Aufruf verarbeiten können. Sie bestimmen auch, wie viel Sie bezahlen, denn jedes gesendete Eingabe-Token wird Ihnen in Rechnung gestellt - auch wenn Sie nicht die gesamte Fensterkapazität nutzen.
Was Kontextfenster sind und wie sie funktionieren
Ein Kontextfenster ist die maximale Anzahl von Token, die ein KI-Modell in einer Anfrage verarbeiten kann. Token sind Textstücke (etwa 4 Zeichen oder 0,75 Wörter pro Token). Wenn Sie eine Eingabeaufforderung senden, zählt jedes Token in dieser Aufforderung zu den Kosten für die Eingabe-Token.
Wichtigster Punkt: Sie zahlen für alle gesendeten Input-Token, unabhängig von der maximalen Kapazität des Modells. Wenn ein Modell 1 Million Token unterstützt, Sie aber nur 50.000 senden, zahlen Sie für diese 50.000 Token und nichts für den Rest des Fensters.
Die Kostenauswirkungen von übergroßen Kontextfenstern
Die Verwendung eines größeren Kontextfensters als nötig verschwendet nicht nur Kapazität, sondern kann durch mehrere Mechanismen unnötige Kosten verursachen:
1. Das Fenster füllen, weil es geht: Ein größeres Fenster verleitet dazu, ganze Dokumente und vollständige Chatverläufe zu senden statt nur der benötigten Teile. Jedes zusätzliche Token wird berechnet.
2. Prompte Inflation: Größere Kontextfenster fördern längere Eingabeaufforderungen. Die Teams fügen mehr Beispiele, mehr Anweisungen und mehr Kontext hinzu, "nur für den Fall". Dies erhöht die Kosten für die Eingabe von Token, ohne die Ergebnisse zu verbessern.
3. Auswahl der Modellebene: Der Preis pro Token unterscheidet sich je nach Stufe, und genau das verändert die Rechnung. Gemini 3 Pro und Gemini 3 Flash haben dasselbe Fenster mit 1.048.576 Token, aber Flash kostet pro Token nur ein Viertel.
Kostenvergleich
Szenario: Verarbeitung von 50K Token-Dokumenten
Eine Marketing-Agentur verarbeitet Kundenforschungsdokumente (durchschnittlich 50.000 Token) durch einen KI-Analyse-Workflow.
Option 1: Verwendung eines 1M-Token-Kontextfensters (Gemini 3 Pro)
- Eingabe-Token pro Anfrage: 50.000
- Eingabekosten: $2,00 pro 1 Mio. Token
- Kosten pro Dokument: (50.000 / 1.000.000) × $2,00 = $0.10
- Monatlich (1.000 Dokumente): $100
Option 2: Verwendung eines 128K-Token-Kontextfensters (GPT-4 Turbo)
- Eingabe-Token pro Anfrage: 50.000
- Eingabekosten: $10,00 pro 1 Mio. Token
- Kosten pro Dokument: (50.000 / 1.000.000) × $10,00 = $0.50
- Monatlich (1.000 Dokumente): $500
In diesem Fall ist das Modell mit dem größeren Fenster (Gemini 3 Pro) günstiger, weil sein Preis pro Token niedriger ist. Die Fenstergröße treibt die Kosten nicht.
Besserer Vergleich: Gleiches Fenster, unterschiedliche Stufe
Szenario: 50K-Token-Dokument, zwei Preisstufen
Strategie 1: Premiumstufe
- Senden von 50K Token an Gemini 3 Pro
- Preise der Premiumstufe: 2,00 $/1M Input
- Kosten: 0,10 $ pro Dokument
Strategie 2: Budgetstufe, gleiche Fenstergröße
- Senden derselben 50K Token an Gemini 3 Flash (ebenfalls 1.048.576 Token Fenster)
- Budgetstufe: 0,50 $/1M Input
- Kosten: 0,025 $ pro Dokument
- Ersparnis: 75 %
Wenn größere Kontextfenster die Kosten wert sind
Größere Kontextfenster rechtfertigen ihre Kosten, wenn Sie die Kapazität tatsächlich benötigen:
Verwenden Sie 1M+ Token-Fenster, wenn:
- Analyse ganzer Codebasen mit vollständigem Repository-Kontext
- Bearbeitung vollständiger Dokumente in Buchform mit detaillierten Abfragen
- Führen von umfangreichen Gesprächsverläufen ohne Zusammenfassung
- Document Intelligence-Plattformen, die große Sammlungen aufnehmen
Verwenden Sie 128K-400K-Fenster, wenn:
- Die meisten Arbeitsabläufe der Geschäftsautomatisierung
- Analyse von Kunden-Support-Tickets
- E-Mail-Verarbeitung und Antwortgenerierung
- Standarddokumentenanalyse und -zusammenfassung
Verwenden Sie 50K-128K-Fenster, wenn:
- Einfache Klassifizierungsaufgaben
- Kurze Dokumentenverarbeitung
- Grundlegende Inhaltserstellung
- Arbeitsabläufe mit hohem Volumen und geringer Komplexität
Wichtige Erkenntnis: Die Fenstergröße ändert nicht den Preis eines Tokens. Wählen Sie das günstigste Modell, dessen Fenster Ihre größte Anfrage fasst und dessen Qualität bei Ihrer Aufgabe überzeugt.
Weitere Informationen zur Berechnung der Token-Kosten finden Sie in unserem Vollständiger Leitfaden zur Berechnung der Kosten von AI-Token.
Versteckte Kostenmultiplikatoren: Wo Ihr Budget verschwindet
Der Basispreis für Token ist nur ein Teil der Geschichte. Wiederholungen, lange Prompts, lange Ausgaben und Ratenlimits erhöhen die Rechnung auf eine Weise, die ein Preis pro Token nicht zeigt.
Wiederholungen und Fehlschläge: Der stille Kostenmultiplikator
Wenn Workflows fehlschlagen, zahlen Sie für Wiederholungen. Formatfehler, Zeitüberschreitungen, Ratenbeschränkungen und Validierungsfehler lösen Wiederholungsversuche aus - und jeder Wiederholungsversuch belastet Sie erneut für dieselbe Anfrage.
Wie Wiederholungen die Kosten vervielfachen:
Szenario: Automatisierung des Kundensupports mit 5% Wiederholungsrate
Ein Support-Team bearbeitet 1.000 Tickets pro Tag mit Hilfe eines KI-Klassifizierungsworkflows.
Grundkosten (keine Wiederholungsversuche):
- Eingabe: 5.000 Token pro Anfrage × 1.000 Anfragen = 5M Token
- Ausgabe: 1.000 Token pro Anfrage × 1.000 Anfragen = 1M Token
- Inputkosten: (5M / 1M) × $2,00 = $10,00
- Produktionskosten: (1M / 1M) × $12,00 = $12,00
- Täglich insgesamt: $22.00
- Monatlicher Gesamtbetrag: $660
Mit 5% Wiederholungsrate:
- Fehlgeschlagene Anfragen: 1.000 × 5% = 50 Wiederholungsversuche pro Tag
- Wiederholungskosten: 50 Anfragen × 0,022 $ = 1,10 $ pro Tag
- Monatliche Kosten für Wiederholungen: $33
- Monatliche Gesamtkosten: 693 $ (5% Erhöhung)
Mit einer Wiederholungsrate von 20 %:
- Fehlgeschlagene Anfragen: 1.000 × 20% = 200 Wiederholungsversuche pro Tag
- Wiederholungskosten: 200 Anfragen × 0,022 $ = 4,40 $ pro Tag
- Monatliche Kosten für Wiederholungen: 132 $
- Monatliche Gesamtkosten: 792 $ (20 % mehr)
Häufige Gründe für Wiederholungen:
- Formatfehler: JSON-Parsing-Fehler, Struktur-Fehlanpassungen
- Zeitüberschreitungen: Anfragen, die Zeitlimits überschreiten
- Ratenbeschränkungen: Überschreitung von API-Anforderungsgrenzen
- Fehler bei der Validierung: Ausgaben, die Geschäftslogikprüfungen nicht bestehen
Strategien zur Verringerung der Kosten für erneute Versuche:
- Implementierung einer strengen JSON-Schema-Validierung vor dem Senden von Anfragen
- Hinzufügen von Timeout-Behandlung und Wiederholungslogik mit exponentiellem Backoff
- Überwachung von Ratenbegrenzungen und Implementierung von Warteschlangen für Anfragen
- Ausgaben vor der Verarbeitung validieren, um Fehler frühzeitig zu erkennen
- Verwenden Sie, wenn möglich, Ausweichmechanismen anstelle von Wiederholungsversuchen.
Lange Prompts: Wie die Länge der Prompts die Input-Kosten beeinflusst
Jedes Token in Ihrem Prompt kostet Geld. Systemprompts, Benutzerprompts, Beispiele und Kontext tragen alle zu den Kosten für Eingabe-Token bei. Das Aufblähen von Prompts - das Hinzufügen von unnötigem Kontext "nur für den Fall" - kann die Kosten erheblich in die Höhe treiben.
Systemaufforderungen gegenüber Benutzeraufforderungen:
Systemaufforderung (wird bei jeder Anfrage gesendet):
- Definiert Modellverhalten, Einschränkungen und Ausgabeformat
- In der Regel 500-2.000 Token
- Wird bei jedem Antrag erhoben
- Beispiel: "Sie sind ein Kundenbetreuer. Geben Sie nur JSON zurück. Bestätigen Sie niemals Zahlungen ohne Überprüfung."
Benutzerabfrage (anfragespezifisch):
- Enthält die eigentliche Aufgabe und die Daten
- Variiert je nach Anfrage
- Beispiel: "Klassifizieren Sie diese Supportanfrage: [Ticketinhalt]"
Auswirkung der Dauer der Aufforderung auf die Kosten:
Szenario: Klassifizierung von Supportanfragen
Kurze Aufforderung (500 Token System + 1.000 Token Benutzer = 1.500 insgesamt):
- Kosten pro Anfrage: (1.500 / 1.000.000) × $2,00 = $0,003
- Monatlich (1.000 Anfragen): $3.00
Lange Eingabeaufforderung (2.000 Token System + 5.000 Token Benutzer = 7.000 insgesamt):
- Kosten pro Anfrage: (7.000 / 1.000.000) × $2,00 = $0,014
- Monatlich (1.000 Anfragen): $14.00
- Kostensteigerung: 367%
Zeitnahe Optimierungsstrategien:
- Redundante Anweisungen aus Systemaufforderungen entfernen
- Verwenden Sie prägnante Beispiele anstelle von ausführlichen Erklärungen
- Eliminieren Sie unnötigen Kontext, der die Ergebnisse nicht verbessert.
- Musteraufforderungen zur Vermeidung von Wiederholungen
- Strategischer Einsatz von Beispielen mit wenigen Bildern (3-5 Beispiele sind oft ausreichend)
Ausgabe von Token-Kosten: Warum die Länge der Antwort die Kosten vervielfacht
Ausgabe-Token kosten mehr als Eingabe-Token: das Dreifache bei GPT-4 Turbo, das Fünffache bei Claude Opus 5.5, das Sechsfache bei Gemini 3 und das Achtfache bei GPT-5.2. Dadurch ist die Antwortlänge ein wichtiger Kostentreiber.
Warum Output-Tokens mehr kosten:
Preisbeispiel GPT-4 Turbo:
- Eingangsmünzen: $10,00 pro 1 Mio. Münzen
- Ausgabe von Token: $30,00 pro 1M Token (3x teurer)
Beispiel für die Preisgestaltung von Claude Opus 5.5:
- Eingabe-Token: 4,00 $ pro 1 Mio. Token
- Ausgabe-Token: 20,00 $ pro 1 Mio. Token (5x teurer)
Auswirkungen der Länge der Antwort auf die Kosten:
Szenario: Arbeitsablauf der Inhaltserstellung
Kurze Antwort (500 Token):
- Ausgabekosten: (500 / 1.000.000) × 20,00 $ = 0,01 $ pro Anfrage
- Monatlich (1.000 Anfragen): 10,00 $
Lange Antwort (2.000 Token):
- Ausgabekosten: (2.000 / 1.000.000) × 20,00 $ = 0,04 $ pro Anfrage
- Monatlich (1.000 Anfragen): 40,00 $
- Kostensteigerung: 300%
Strategien zur Senkung der Output-Token-Kosten:
- Begrenzung der Antwortlänge mit
max_tokensParameter - Verwenden Sie strukturierte Ausgaben (JSON) anstelle von ausführlichem Text
- Bitten Sie um kurze Zusammenfassungen anstelle von ausführlichen Erklärungen
- Verwenden Sie Vorlagen, um Antworten effizient zu formatieren
- Zwischenspeicherung von Antworten für wiederholte Abfragen implementieren
Kosten für Tarifgrenzen: Wenn Limits Stufenaufstiege erzwingen
Ratenlimits bestimmen, wie viele Anfragen Sie pro Minute, Stunde oder Tag stellen können. Wenn Sie an die Ratengrenzen stoßen, müssen Sie entweder warten (was die Arbeitsabläufe verzögert) oder eine höhere Stufe wählen (was die Kosten erhöht).
Wie Tarifgrenzen die Kosten treiben:
Szenario: Arbeitsabläufe mit hohem Volumen stoßen an die Grenzen des kostenlosen Bereichs
Eine Marketingagentur verarbeitet 10.000 Leads pro Tag über einen KI-Qualifizierungsworkflow.
Grenzen der kostenlosen Ebene:
- 1.000 Anfragen pro Stunde
- Bearbeitungszeit: 10 Stunden (mit Verzögerungen)
- Verzögerungen im Arbeitsablauf: 6+ Stunden täglich
- Auswirkungen: Verspätete Antworten, verpasste Chancen
Bezahlter Stufenaufstieg:
- 10.000 Anfragen pro Stunde
- Bearbeitungszeit: 1 Stunde
- Zusätzliche Kosten: ein höherer Monatstarif
- Kompromiss: Höhere Kosten, aber schnellere Verarbeitung, keine verpassten Chancen
Versteckte Kosten von Höchstsätzen:
- Warteschlangenverzögerungen, die Arbeitsabläufe verlangsamen
- Kosten für Wiederholungen aufgrund von Grenzwertüberschreitungen
- Erzwungene Stufenaufstiege, wenn die Grenzwerte zu restriktiv sind
- Opportunitätskosten durch verzögerte Bearbeitung
Strategien zur Verwaltung von Ratenobergrenzen:
- Testen Sie das erwartete Volumen anhand der Plattformgrenzen, bevor Sie sich festlegen.
- Implementierung von Warteschlangen und Stapelverarbeitung von Anfragen
- Verwendung von Stapelverarbeitungs-APIs, wenn verfügbar (oft 50 % billiger)
- Erwägen Sie mehrere API-Schlüssel für höhere Grenzwerte
- Überwachen Sie die Nutzung von Ratenobergrenzen und passen Sie die Arbeitsabläufe entsprechend an.
Realitätsprüfung: Wiederholungen, lange Prompts und Ratenlimits summieren sich. Ein Workflow mit 20 % Wiederholungsrate zahlt 20 % mehr für dieselbe Arbeit, bevor Sie irgendetwas anderes mitrechnen. Planen Sie das von Anfang an ein.
Abwägung zwischen "intelligenteren" und "billigeren" Modellen
Bei der Entscheidung zwischen Premium- und Budget-KI-Modellen geht es nicht nur um Fähigkeiten, sondern auch um eine Kosten-Nutzen-Analyse. Wenn Sie wissen, wann günstigere Modelle ausreichen und wann Premium-Modelle höhere Kosten rechtfertigen, können Sie Ihre Ausgaben optimieren, ohne Abstriche bei der Qualität zu machen.
Analyse von Kosten und Fähigkeiten
Preisgünstige Modelle (GPT-4o Mini, Gemini 3 Flash):
- Input: 0,15-0,50 $ pro 1M Token
- Ausgabe: 0,60-3,00 $ pro 1M Token
- Fähigkeiten: Gut für einfache Aufgaben, Klassifizierung, Basisgenerierung
- Am besten geeignet für: Arbeitsabläufe mit hohem Volumen und geringer Komplexität
Modelle der Premiumklasse (GPT-5.2, Claude Opus 5.5):
- Input: 1,75-4,00 $ pro 1M Token
- Ausgabe: 14,00-20,00 $ pro 1M Token
- Befähigung: Fortgeschrittenes logisches Denken, Codierung, komplexe Analyse
- Am besten geeignet für: Komplexe Aufgaben, bei denen Fehler in der Genauigkeit teuer sind
Wenn billigere Modelle ausreichen
Verwenden Sie Budgetebenen, wenn:
- Einfache Klassifizierungsaufgaben (E-Mail-Routing, Lead-Qualifizierung)
- Einfache Inhaltserstellung (Vorlagen, Zusammenfassungen)
- Workflows mit hohem Volumen, bei denen die Kosten pro Anfrage eine Rolle spielen
- Aufgaben, bei denen gelegentliche Fehler akzeptabel sind
- Prototyping und Tests
Rechenbeispiel: Eine Lead-Qualifizierung, die mit GPT-4o Mini (0,15 $/1M Input, 0,60 $/1M Output) 45 $ im Monat kostet, würde mit GPT-5.2 etwa 12- bis 23-mal so viel kosten, weil der Input-Preis von GPT-5.2 etwa 12-mal und der Output-Preis etwa 23-mal höher ist. Prüfen Sie, ob die Antworten des Budgetmodells reichen, bevor Sie dafür bezahlen.
Wenn Premium-Modelle höhere Kosten rechtfertigen
Verwenden Sie die Premium-Stufen, wenn:
- Komplexe Argumentationsaufgaben (Finanzanalyse, strategische Planung)
- Kodierung und Entwicklungsautomatisierung (wo Fehler kostspielig sind)
- Compliance-kritische Arbeitsabläufe (wo Ausfälle ein Risiko darstellen)
- Aufgaben, bei denen die Verbesserung der Genauigkeit die 10-fachen Kosten rechtfertigt
- Arbeitsabläufe mit geringem Volumen und hohem Wert
Wann sich Premium lohnt: Bei der Vertragsanalyse kann eine übersehene Klausel mehr kosten als ein Jahr API-Aufrufe. Dann lohnt es sich, den höheren Preis pro Token gegen ein Budgetmodell zu testen.
Effizienzunterschiede bei Token
Einige Modelle erzielen ähnliche Ergebnisse mit weniger Token, was die höheren Kosten pro Token ausgleichen kann:
Token-Effizienz:
- Manche Modelle brauchen für dieselbe Aufgabe weniger Token als andere
- Ein höherer Preis pro Token (4 $/20 $ bei Claude Opus 5.5 gegenüber 1,75 $/14 $ bei GPT-5.2) kann trotzdem eine niedrigere Rechnung bedeuten, wenn weniger Token nötig sind
- Messen Sie die Token pro Aufgabe mit Ihrer eigenen Arbeitslast, bevor Sie vergleichen
Entscheidungsrahmen:
| Faktor | Budget Tier | Premium Tier |
|---|---|---|
| Am besten geeignet für | Großes Volumen, einfache Aufgaben | Komplexe Argumentation, Codierung |
| Wann zu verwenden | Kostensensitive Workflows | Genauigkeitsrelevante Workflows |
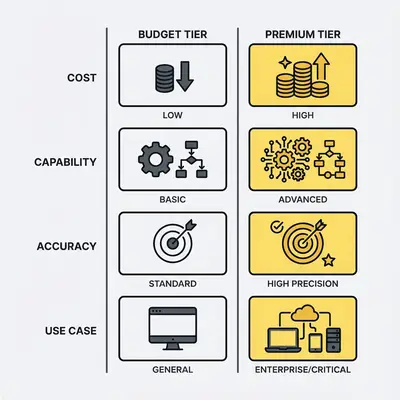
Profi-Tipp: Nutzen Sie abgestuftes Routing. Senden Sie einfache Aufgaben mit hohem Volumen an eine Budgetstufe, die nur einen Bruchteil des Premium-Preises kostet, und komplexe, genauigkeitskritische Aufgaben an eine Premiumstufe.
Optimierungsstrategien zur Kostensenkung
Bei der Kostenoptimierung geht es nicht darum, das billigste Modell zu wählen. Es geht darum, jeden Bestandteil Ihres Automatisierungsworkflows richtig zu dimensionieren.
Optimierung des Kontextfensters
Die richtige Größe für den tatsächlichen Bedarf:
- Senden Sie nur die Teile eines Dokuments, die die Aufgabe braucht
- Wählen Sie Budgetebenen mit angemessenen Kontextfenstern
- Zahlen Sie nicht für Kapazitäten, die Sie nicht nutzen werden
Chunking-Strategien für lange Dokumente:
- 200K Token-Dokumente in 4×50K-Stücke aufteilen
- Stücke getrennt verarbeiten und Ergebnisse kombinieren
- Chunking verringert die gesendeten Token nicht. Es erlaubt Ihnen, irrelevante Abschnitte zu überspringen, und macht Dokumente verarbeitbar, die größer als das Fenster sind.
Wann sollten größere und wann kleinere Fenster verwendet werden?
- Verwenden Sie größere Fenster, wenn Kontextbeziehungen von Bedeutung sind (Codebases, lange Unterhaltungen)
- Verwenden Sie kleinere Fenster, wenn die Dokumente unabhängig sind (Stapelverarbeitung, Klassifizierung)
Zeitnahe Optimierung
Reduzieren Sie die Promptlänge ohne Qualitätsverlust:
- Redundante Anweisungen entfernen
- Verwenden Sie prägnante Beispiele (3-5 kurze Beispiele reichen oft aus)
- Unnötiger Kontext wird eliminiert
- Musteraufforderungen zur Vermeidung von Wiederholungen
Effizienz der Systemabfrage:
- Halten Sie die Systemaufforderungen nach Möglichkeit unter 1.000 Token
- Entfernen Sie Anweisungen, die die Ergebnisse nicht verbessern
- Verwenden Sie strukturierte Formate, um die Ausführlichkeit zu reduzieren.
Optimierung der Vorlagen:
- Wiederverwendbare Prompt-Vorlagen erstellen
- Variableninhalt parametrisieren
- Vermeiden Sie die Wiederholung von statischen Anweisungen
Beispiel für Einsparungen:
- Reduzierung der Souffleure von 7.000 auf 1.500 Token spart 79 % der Inputkosten
- Monatliche Einsparungen: $11 bei 1.000 Anfragen (von $14 auf $3)
Optimierung der Ausgabe
Länge der Antwort begrenzen:
- Verwenden Sie
max_tokensParameter zur Begrenzung der Antworten - Bitten Sie um kurze Zusammenfassungen anstelle von ausführlichen Erklärungen
- Exakte Ausgabeformate angeben
Strukturierte Ausgaben zur Reduzierung von Token:
- JSON anstelle von ausführlichem Text verwenden
- Nur bestimmte Felder anfordern
- Vermeiden Sie erklärenden Text, wenn die Daten ausreichen.
Strategien zur Formatierung von Antworten:
- Verwenden Sie Vorlagen für eine einheitliche, effiziente Formatierung
- Aufzählungspunkte anstelle von Absätzen anfordern
- Legen Sie Zeichengrenzen für jedes Feld fest
Beispiel für Einsparungen:
- Die Begrenzung der Antworten von 2.000 auf 500 Token spart 75 % der Produktionskosten
- Monatliche Einsparungen: 30 $ bei 1.000 Anfragen (von 40 $ auf 10 $ zu Claude-Opus-5.5-Preisen)
Optimierung der Modellauswahl
Stufenweises Routing:
- Einfache Aufgaben → Budgetstufe (GPT-4o Mini, Gemini 3 Flash)
- Komplexe Aufgaben → Premiumstufe (GPT-5.2, Claude Opus)
- Routenplanung basierend auf der Komplexität der Aufgabe, nicht nur auf dem Volumen
Hybride Ansätze:
- Verwenden Sie die Budgetebene für einfache Arbeitsabläufe mit hohem Volumen.
- Verwenden Sie die Premium-Stufe für komplexe Workflows mit geringem Volumen.
- Optimierung der Streckenführung auf der Grundlage einer tatsächlichen Kosten-Nutzen-Analyse
Überwachung und Anpassung der Kosten:
- Verfolgung der Kosten nach Modellstufe und Arbeitsablauf
- Ermittlung von Möglichkeiten zur Herab- oder Heraufstufung von Ebenen
- Anpassung des Routings auf der Grundlage von Leistungs- und Kostendaten
Wiederholungen und Fehlerreduzierung
Validierungsstrategien:
- Eingaben vor dem Senden an die API validieren
- JSON-Schema-Validierung implementieren
- Prüfen Sie, ob Felder und Formate erforderlich sind
Fehlerbehandlung, um Wiederholungsversuche zu vermeiden:
- Implementierung eines exponentiellen Backoffs für Wiederholungsversuche
- Festlegen von Höchstgrenzen für Wiederholungsversuche
- Fallback-Mechanismen anstelle von unendlichen Wiederholungsversuchen
Fallback-Mechanismen:
- Weg zu alternativen Modellen bei Misserfolg
- Zwischengespeicherte Antworten für wiederholte Abfragen verwenden
- Implementierung von Human-in-the-Loop für Grenzfälle
Beispiel für Einsparungen:
- Reduzierung der Wiederholungsrate von 20 % auf 5 % spart 99 $/Monat bei einem Workflow mit 1.000 Anfragen/Tag
Profi-Tipp: Die Optimierung erfolgt iterativ. Beginnen Sie mit den größten Kostentreibern (Ausgabe-Token, Kontextfenster) und messen Sie die Auswirkungen. Optimieren Sie dann die Prompts, reduzieren Sie die Wiederholungsversuche und nehmen Sie eine Feinabstimmung der Modellauswahl vor. Die meisten Teams können mit diesen Strategien eine Kostensenkung von 50-70 % erreichen.
Wenn Sie Hilfe bei der Optimierung Ihrer KI-Automatisierungskosten benötigen, können wir Ihre Arbeitsabläufe analysieren und in weniger als 30 Minuten Einsparungsmöglichkeiten ermitteln. Buchen Sie eine kostenlose Kostenanalyse.
Durchgerechnete Kostenszenarien
Diese Szenarien zeigen, wie Kontextfenster, versteckte Kosten und Optimierungsstrategien reale Automatisierungsabläufe beeinflussen.
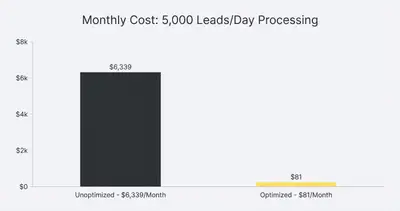
Szenario 1: Hochvolumige Bleiverarbeitung
Arbeitsbelastung: Marketing-Agentur verarbeitet 5.000 Leads pro Tag durch KI-Qualifizierungsworkflow.
Ersteinrichtung (unoptimiert):
- Prompt-Länge: 5.000 Token pro Anfrage (ausführlicher Systemprompt + Beispiele)
- Ausgabelänge: 2.000 Token pro Antwort (ausführliches JSON mit Erläuterungen)
- Wiederholungsrate: 15% (Formatfehler, Timeouts)
- Modell: GPT-5.2 ($1,75/1M Eingang, $14/1M Ausgang)
Monatliche Kosten:
- Eingabe: (5.000 × 30 × 5.000 / 1.000.000) × $1,75 = $1.312,50
- Ausgabe: (5,000 × 30 × 2,000 / 1,000,000) × $14.00 = $4,200.00
- Wiederholungen (15%): ($1.312,50 + $4.200,00) × 15% = $826,88
- Gesamt: 6.339,38 $/Monat
Optimierte Einrichtung:
- Aufforderungslänge: 1.500 Token (optimierte Systemaufforderung, prägnante Beispiele)
- Ausgabelänge: 500 Token (strukturiertes JSON, keine Erläuterungen)
- Wiederholungsrate: 3% (Validierung, Fehlerbehandlung)
- Modell: GPT-4o Mini ($0,15/1M Eingang, $0,60/1M Ausgang)
Monatliche Kosten:
- Input: (5.000 × 30 × 1.500 / 1.000.000) × $0,15 = $33,75
- Ausgabe: (5,000 × 30 × 500 / 1,000,000) × $0.60 = $45.00
- Wiederholungen (3%): ($33,75 + $45,00) × 3% = $2,36
- Gesamt: $81,11/Monat
- Einsparungen: $6.258,27/Monat (98,7% Reduzierung)
Szenario 2: Arbeitsablauf der Dokumentenanalyse
Arbeitsbelastung: Die Anwaltskanzlei analysiert 500 Verträge pro Monat (durchschnittlich 100.000 Token pro Vertrag).
Strategie 1: Premiummodell
- Verwendung von Claude Opus 5.5 (1M-Token-Fenster)
- Übermittlung von 100K Token-Dokumenten in einer einzigen Anfrage
- Kosten: (500 × 100.000 / 1.000.000) × 4,00 $ = 200 $/Monat
Strategie 2: Budgetmodell, gleicher vollständiger Kontext
- Verwendung von Gemini 3 Flash (Fenster mit 1.048.576 Token)
- Jedes Dokument mit 100K Token passt weiterhin in eine Anfrage
- Kosten: (500 × 100.000 / 1.000.000) × 0,50 $ = 25 $/Monat
- Einsparungen: 175 $/Monat (87,5 % Reduzierung gegenüber Strategie 1)
Anmerkung: Ein älteres Premiummodell wie GPT-4 Turbo (10 $/1M Input) würde für dieselben Dokumente 500 $/Monat kosten. Der Preis pro Token treibt die Rechnung, nicht die Fenstergröße.
Kompromiss: Das Chunking erfordert die Kombination von Ergebnissen, aber die Kosteneinsparungen rechtfertigen den zusätzlichen Verarbeitungsschritt für die meisten Anwendungsfälle.
Szenario 3: Automatisierung der Kundenbetreuung
Arbeitsbelastung: Das Support-Team bearbeitet 2.000 Tickets pro Tag durch KI-Triage und die Erstellung von Antworten.
Nicht optimierte Kosten:
- Lange Eingabeaufforderungen: 7.000 Token pro Anfrage
- Ausführliche Ausgaben: 2.000 Token pro Antwort
- Hohe Wiederholungsrate: 20% (Formatfehler)
- Modell: Claude Opus 5.5 (4 $/1M Eingang, 20 $/1M Ausgang)
Monatliche Kosten:
- Eingabe: (2.000 × 30 × 7.000 / 1.000.000) × 4,00 $ = 1.680,00 $
- Ausgabe: (2.000 × 30 × 2.000 / 1.000.000) × 20,00 $ = 2.400,00 $
- Wiederholungen (20 %): (1.680 $ + 2.400 $) × 20 % = 816,00 $
- Insgesamt: 4.896,00 $/Monat
Optimierte Kosten:
- Optimierte Prompts: 1.500 Token pro Anfrage
- Strukturierte Ausgaben: 500 Token pro Antwort
- Niedrige Wiederholungsrate: 3% (Validierung, Fehlerbehandlung)
- Modell: GPT-4o Mini ($0,15/1M Eingang, $0,60/1M Ausgang)
Monatliche Kosten:
- Input: (2.000 × 30 × 1.500 / 1.000.000) × $0,15 = $13,50
- Ausgabe: (2,000 × 30 × 500 / 1,000,000) × $0.60 = $18.00
- Wiederholungen (3%): ($13,50 + $18,00) × 3% = $0,95
- Gesamt: 32,45 $/Monat
- Ersparnis: 4.863,55 $/Monat (99,3 % Reduzierung)
Szenario 4: Arbeitsablauf der Codegenerierung
Arbeitsbelastung: Das Entwicklungsteam erstellt 200 Codedateien pro Monat mit Hilfe von KI.
Anforderungen:
- Vollständiger Codebase-Kontext erforderlich (500K Token)
- eine hohe Codequalität erfordern (Premium-Modell)
- Ausgabe: 5.000 Token pro Datei
Verwendung von Claude Opus 5.5 (Premiumstufe):
- Eingabe: (200 × 500.000 / 1.000.000) × 4,00 $ = 400,00 $
- Ausgabe: (200 × 5.000 / 1.000.000) × 20,00 $ = 20,00 $
- Gesamt: 420,00 $/Monat
Optimierungsstrategien:
- Prompt-Caching für den wiederholten Codebase-Kontext nutzen (Cache-Lesezugriffe kosten bei Claude Opus 5.5 5 % des normalen Input-Preises)
- Beschränkung der Ausgabe auf den wesentlichen Code (Reduzierung von 5.000 auf 3.000 Token)
- Validierung implementieren, um Wiederholungsversuche zu reduzieren
Optimierte Kosten:
- Eingabe mit Zwischenspeicherung: etwa 20,00 $ zuzüglich Kosten für Cache-Schreibvorgänge (100 Mio. Token zu 0,20 $ pro Million)
- Optimierte Ausgabe: 12,00 $ (3.000 Token pro Datei)
- Gesamt: etwa 32,00 $/Monat zuzüglich Cache-Schreibvorgänge
- Einsparung: etwa 388,00 $/Monat (etwa 92 % Reduzierung)
Anmerkung: Bei der Codegenerierung sind Premium-Modelle oft gerechtfertigt, da Fehler in der Codequalität teuer sind. Die Optimierung konzentriert sich auf die Reduzierung des Tokenverbrauchs bei gleichzeitiger Beibehaltung der Qualität.
Schlussfolgerung: Kostenkontrolle durch Verständnis der Mechanik
Token-Limits und Kontextgröße beeinflussen die Kosten der KI-Automatisierung auf eine Weise, die die meisten Teams überrascht. Das Verständnis dieser Mechanismen - und nicht nur die Preisgestaltung pro Token - hilft Ihnen, Ihr Budget genau zu planen und effektiv zu optimieren.
Die wichtigsten Erkenntnisse:
Wählen Sie Modelle nach Preis pro Token, nicht nach Fenstergröße. Ein größeres Fenster macht ein Token nicht teurer. Wählen Sie das günstigste Modell, dessen Fenster Ihre größte Anfrage fasst und dessen Qualität überzeugt.
Versteckte Kosten summieren sich. Wiederholungen, lange Prompts, Ausgabe-Token und Ratenlimits können die Kosten deutlich über den Basispreis pro Token treiben. Planen Sie sie von Anfang an ins Budget ein.
Optimierungsstrategien senken die Kosten. Kürzere Prompts und Ausgaben, abgestuftes Routing und weniger Wiederholungen senken die Rechnung. Die Szenarien oben zeigen, wie stark, je nach Ausgangslage.
Nächste Schritte:
- Prüfen Sie Ihre aktuellen Kosten: Identifizieren Sie Ihre größten Kostentreiber (Ausgabe-Token, Kontextfenster, Wiederholungsversuche, Promptlänge)
- Kontextfenster in der richtigen Größe: Anpassen der Fenstergröße an die tatsächliche Dokument-/Aufgabengröße
- Optimieren Sie Prompts und Ausgaben: Reduzierung der Länge ohne Qualitätseinbußen
- Implementieren Sie abgestuftes Routing: Leiten Sie einfache Aufgaben an Budget-Ebenen und komplexe Aufgaben an Premium-Ebenen weiter.
- Wiederholungsversuche reduzieren: Validierung, Fehlerbehandlung und Fallback-Mechanismen hinzufügen
- Überwachen und anpassen: Verfolgung der Kosten nach Arbeitsabläufen und Anpassung der Strategien auf der Grundlage der Daten
Der Unterschied zwischen einer erwarteten Rechnung in Höhe von 500 US-Dollar und einer tatsächlichen Rechnung in Höhe von 2.300 US-Dollar ist kein Fehler - es sind die versteckten Kostenmechanismen, die die meisten Teams nicht verstehen, bis die Rechnung eintrifft. Wenn Sie diese Mechanismen verstehen und Optimierungsstrategien implementieren, kann die Automatisierung in großem Umfang nachhaltig sein.
Sind Sie bereit, Ihre AI-Automatisierungskosten zu optimieren? Buchen Sie eine Demo mit Evalics um eine personalisierte Kostenanalyse und einen Optimierungsplan für Ihre spezifischen Arbeitsabläufe zu erhalten.
Von Kevin Michael Schindler, Experte für KI-Automatisierung bei Evalics