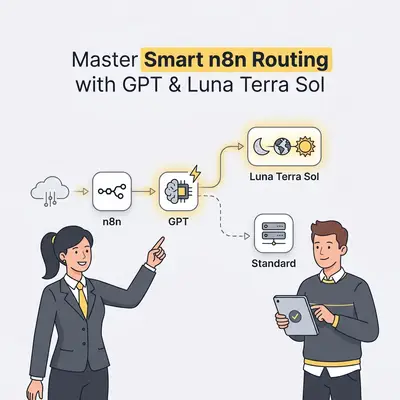
Das dynamische Modell-Routing leitet eingehende Aufgaben automatisch an verschiedene KI-Modelle weiter, je nach Komplexität der Anfrage, Domänenanforderungen oder Kostenbeschränkungen. Anstatt jede Anfrage über ein einziges, ressourcenintensives LLM zu verarbeiten, nutzt ein n8n-Routing-Workflow ein leichtgewichtiges Modell oder einen Klassifikator-Knoten, um die eingehende Eingabe zu bewerten. Das System leitet die Aufgabe dann an die kosteneffizienteste Ebene weiter – beispielsweise an GPT-5.6 Luna für routinemäßige Klassifizierungen, an Terra für alltägliche Geschäftsaufgaben oder an Sol für komplexe Schlussfolgerungen und fortgeschrittene Programmierung.
Die GPT-5.6-Modellfamilie verstehen
- GPT-5.6 Luna: Das kosteneffizienteste Modell von OpenAI, entwickelt für einfache Aufgaben mit hohem Durchsatz wie Dokumentenklassifizierung, Textextraktion und grundlegende Triage im Kundensupport.
- GPT-5.6 Terra: Ein ausgewogenes Modell, das für den alltäglichen Geschäftsbetrieb, administrative Arbeitsabläufe, die Erstellung von Inhaltsentwürfen und mittleres logisches Denken konzipiert ist.
- GPT-5.6 Sol: Das Flaggschiff-Modell von OpenAI, das für Aufgaben mit hohem Risiko entwickelt wurde, darunter fortgeschrittene Softwareentwicklung, komplexe Datenanalyse und die Koordination mehrstufiger, agentenbasierter Abläufe. Laut OpenAI erreichte GPT-5.6 Sol 53,6 Punkte bei „Agents’ Last Exam“, einem Benchmark für lang laufende berufliche Workflows in 55 Fachgebieten. Dieser Wert stammt aus dem eigenen Launch-Beitrag von OpenAI und ist nicht unabhängig geprüft.
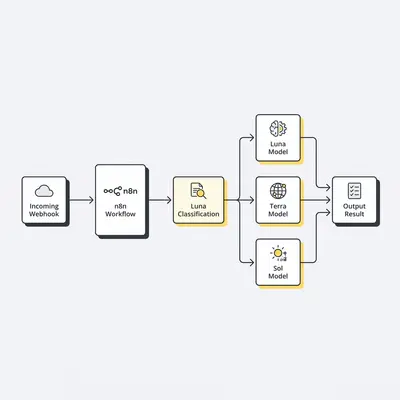
Schritt 1: Wie richtet man den ersten Webhook-Trigger in n8n ein?
Um das dynamische Routing zu initiieren, konfigurieren Sie zunächst einen Webhook-Trigger-Knoten in n8n, der eingehende Datenanfragen von Ihren Geschäftsanwendungen, Webformularen oder Chat-Schnittstellen entgegennimmt. Dieser Knoten bietet Ihren Aufrufern einen stabilen Endpunkt und erfasst gleichzeitig die Rohdaten der Nutzlast.
- Fügen Sie Ihrem Arbeitsbereich einen Webhook-Knoten hinzu und stellen Sie die HTTP-Methode auf
POSTein. - Setzen Sie den Parameter „Respond“ auf
Using Respond to Webhook Node, damit Ihr Workflow nach Abschluss strukturierte KI-Ausgaben an den Aufrufer zurücksenden kann. - Kopieren Sie die Test-URL und lösen Sie eine Beispiel-Nutzlast aus, die ein
user_prompt-Feld enthält, um Ihre Basisdatenstruktur festzulegen.
Schritt 2: Wie erstellen Sie die Klassifizierungs-Eingabeaufforderung mit GPT-5.6 Luna?
Verwenden Sie ein kostengünstiges Modell wie GPT-5.6 Luna, um die eingehende Eingabe zu bewerten und ihr eine Kategorie zuzuweisen, ohne dass hohe Token-Gebühren anfallen. Der primäre Klassifikator bewertet die Absicht, anstatt vollständige Antworten zu generieren.
- Fügen Sie einen OpenAI Chat Model-Knoten hinzu, der mit einem Basic Chain- oder HTTP Request-Knoten verbunden ist.
- Stellen Sie das Modell auf
gpt-5.6-lunaein. - Konfigurieren Sie die System-Prompt so, dass sie JSON zurückgibt, das die Eingabe in eine von drei vordefinierten Kategorien einordnet:
simple,standardodercomplex.
Profi-Tipp: Halten Sie den Umfang Ihrer Klassifikator-System-Prompt eng gefasst. Stellen Sie sicher, dass der Klassifizierungsschritt ausschließlich die Struktur und die Absicht der Eingabe analysiert, anstatt die zugrunde liegende Aufgabe zu lösen.
Schritt 3: Wie standardisieren Sie Ausgaben mit einem strukturierten Parser?
Um sicherzustellen, dass Ihr Workflow korrekt weitergeleitet wird, wenden Sie mithilfe des „Structured Output Parser“ von n8n ein striktes JSON-Schema auf Ihren Klassifizierungsschritt an. Dies garantiert, dass die Modellausgabe genau mit Ihren Schlüsselnamen und den erwarteten Zeichenfolgen übereinstimmt.
- Fügen Sie Ihrem Klassifikator-Knoten einen Structured Output Parser-Knoten hinzu.
- Definieren Sie ein Ausgabeschema, das einen Schlüssel namens
task_categoryerfordert, dessen Werte streng aufsimple,standardodercomplexbeschränkt sind. - Aktivieren Sie die Optionen zur automatischen Korrektur, damit der Klassifikator automatisch erneut abgefragt wird, falls ungültiges JSON erzeugt wird.
Schritt 4: Wie konfigurieren Sie den n8n-Switch-Knoten für die Modellauswahl?
Der Switch-Knoten fungiert als Verkehrsleiter und leitet die Ausführung basierend auf der Ausgabe des Klassifikators in bestimmte Zweige. Die explizite Zuordnung dieser Werte verhindert Ausführungsfehler im weiteren Verlauf.
- Fügen Sie direkt nach Ihrem Parser einen Switch-Knoten im Regelmodus hinzu.
- Fügen Sie Regel 1 hinzu: Geben Sie den Zweig
0aus, wenn{{ $json.task_category }}gleichsimpleist. - Fügen Sie Regel 2 hinzu: Geben Sie den Zweig
1aus, wenn{{ $json.task_category }}gleichstandardist. - Fügen Sie Regel 3 hinzu: Geben Sie den Zweig
2aus, wenn{{ $json.task_category }}gleichcomplexist.
Schritt 5: Wie verbinden Sie die einzelnen Routing-Zweige mit Luna, Terra und Sol?
Verbinden Sie jeden Ausgangs-Pin des Switch-Knotens mit einem OpenAI-Chat-Knoten, der auf die jeweilige Komplexitätsstufe zugeschnitten ist. Durch die Abstimmung der Aufgabenanforderungen auf die Modellstufen bleibt die Verarbeitung schnell und der Token-Verbrauch vorhersehbar.
- Verbinden Sie Ausgang 0 (einfach) mit einem OpenAI-Knoten, der mit
gpt-5.6-lunakonfiguriert ist, um eine schnelle und kostengünstige Verarbeitung zu gewährleisten. - Verbinden Sie Ausgang 1 (Standard) mit einem OpenAI-Knoten, der auf
gpt-5.6-terraeingestellt ist, für eine ausgewogene Verarbeitung alltäglicher Aufgaben. - Verbinden Sie Ausgang 2 (komplex) mit einem OpenAI-Knoten, der auf
gpt-5.6-soleingestellt ist (mit „Reasoning“ auf „hoch“ oder „max“), um anspruchsvolle Analyse- oder Programmieraufgaben zu bewältigen.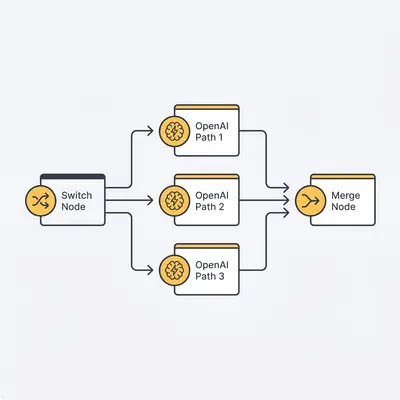
Schritt 6: Wie konsolidiert man Antworten mit einem „Merge“-Knoten?
Nachdem das ausgewählte Modell die Anfrage verarbeitet hat, führen Sie die Ausführungspfade zu einer einzigen Pipeline zusammen, um die Nachbearbeitung zu optimieren. Ein einziger nachgelagerter Pfad vereinfacht die Datenformatierung und die Fehlerbehandlung.
- Fügen Sie dem Canvas einen „Merge“-Knoten hinzu.
- Stellen Sie den Merge-Modus auf „Choose Branch“ oder „Pass Through“ ein.
- Verbinden Sie die Ausgänge der Ausführungsknoten „Luna“, „Terra“ und „Sol“ mit den Eingangsanschlüssen des Merge-Knotens.
Schritt 7: Wie senden Sie die endgültige Antwort an Ihre Anwendung zurück?
Schließen Sie den Workflow ab, indem Sie die generierte Antwort über einen „Webhook-Antwort“-Knoten an den ursprünglichen Aufrufer zurückgeben. Dadurch wird die asynchrone HTTP-Verbindung sauber geschlossen.
- Fügen Sie im Anschluss an den „Merge“-Knoten einen „Respond to Webhook“-Knoten hinzu.
- Legen Sie den Antworttext auf JSON fest und ordnen Sie das Ergebnisfeld zu:
{{ $json.message.content }}. - Speichern und aktivieren Sie Ihren n8n-Workflow, um mit der Verarbeitung des dynamischen Modell-Routings in Echtzeit zu beginnen.
Schneller Erfolg: Stellen Sie Ihren Webhook-Knoten so ein, dass er bei der ersten Bereitstellung Ausführungs-IDs in die Rückgabedaten einbezieht. Auf diese Weise können Sie nachgelagerte Client-Protokolle direkt mit den n8n-Ausführungsverläufen korrelieren.
Nachfolgend finden Sie einen produktionsreifen JSON-Schema-Ausschnitt für Ihren n8n-Knoten „Structured Output Parser“. Sie können diesen direkt in Ihre Workflow-Konfiguration einfügen, um standardisierte Routing-Ausgaben zu gewährleisten:
{
  "$schema": "http://json-schema.org/draft-07/schema#",
  "title": "ModelRoutingSchema",
  "type": "object",
  "properties": {
    "task_category": {
 "type": "string",
 "enum": ["simple", "standard", "complex"],
 "description": "Die Kategorie der Aufgabe basierend auf dem Aufwand für die Schlussfolgerung. Einfach: einfache Nachschlagevorgänge, Formatierung, grundlegende Klassifizierung. Standard: Textzusammenfassung, Verfassen von E-Mails, Standardlogik. Komplex: mehrstufige mathematische Berechnungen, Codegenerierung, detaillierte Recherche."
    },
    "reasoning_summary": {
 "type": "string",
 "description": "Eine kurze, einsatzige Begründung für die gewählte Klassifizierungskategorie."
    }
  },
  "required": ["task_category", "reasoning_summary"],
  "additionalProperties": false
}
Was sind häufige Fallstricke beim n8n-AI-Modell-Routing?
- Klassifizierungsaufwand: Die Verwendung eines Modells, das für die Klassifizierung einfacher Aufgaben zu groß ist, kann die Kosteneinsparungen durch dynamisches Routing zunichte machen. Halten Sie die Klassifikator-Eingabeaufforderung prägnant und nutzen Sie GPT-5.6 Luna.
- Unstrukturierte Klassifikator-Antworten: Wenn die Ausgabe des Klassifikators nicht streng validiert wird, führen Zeichenfolgenabweichungen (z. B. „Simple“ vs. „simple“) dazu, dass der Switch-Knoten fehlschlägt oder durchfällt.
- Fehlende Fallback-Zweige: Wenn Sie in Ihrem Switch-Knoten keine Standardroute definieren, kann dies zu einem Stillstand der Ausführung führen, falls eine Abfrage außerhalb der erwarteten Kategorien liegt. Leiten Sie nicht erkannte Eingaben stets an eine ausgewogene Ebene wie GPT-5.6 Terra weiter.
Realitätscheck: Das Leiten jeder Eingabe über einen Bewertungsknoten erhöht die Latenz jeder Anfrage um einige hundert Millisekunden. Stellen Sie sicher, dass Ihr geschäftlicher Anwendungsfall Kostenkontrolle und Leistung gegenüber minimaler Latenz priorisiert, bevor Sie komplexe Klassifizierungsschritte hinzufügen.
Checkliste für die Implementierung des dynamischen n8n-Routings
- Webhook-Trigger mit POST-Methode und Erfassung der Rohdaten konfiguriert.
- Prompt des Klassifizierungssystems für prägnante JSON-Ausgabe optimiert.
- Strukturierter Ausgabeparser angehängt und Schema validiert.
- Switch-Knoten mit expliziten Routing-Regeln für einfache, standardmäßige und komplexe Pfade konfiguriert.
- API-Schlüssel und Modellparameter für die GPT-5.6-Knoten „Luna“, „Terra“ und „Sol“ zugewiesen.
- Fallback-Pfad am Switch-Knoten für nicht klassifizierte Randfälle definiert.
- Merge-Knoten integriert, um Modellausgaben vor der Payload-Übermittlung zusammenzuführen.
- „Respond to Webhook“-Knoten konfiguriert, um die asynchrone HTTP-Schleife zu schließen.
Um Ihre Routing-Konfiguration zu erweitern, lesen Sie unsere Anleitung zum n8n-Switch-Knoten oder erfahren Sie in unserem Leitfaden zum n8n Queue Mode, wie Sie skalieren. Dasselbe Muster funktioniert mit den Modellstufen jedes Anbieters, sodass Sie neuere Modelle einsetzen können, ohne den Workflow neu aufzubauen.
Quellen
- GPT-5.6 - OpenAI
- GPT-5.6 Benchmark Review: Sol, Terra, and Luna Across 12 Benchmarks - LayerLens