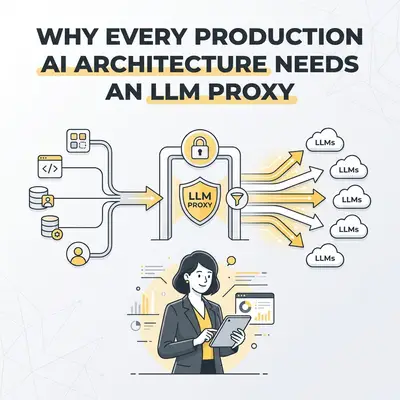
Ein LLM-Proxy ist ein Gateway-Server zwischen Ihrem Anwendungscode und Ihren Modellanbietern. Ihre Apps rufen einen einzigen Endpunkt auf, und der Proxy leitet jede Anfrage an OpenAI, Anthropic, Google oder einen anderen Anbieter weiter.
Viele Teams beginnen damit, einen API-Schlüssel des Anbieters direkt in den Code einzubinden. Für einen Prototyp reicht das. In der Produktion verteilen sich dann Schlüsselverwaltung, Retries, Kostenerfassung und Logging auf jeden einzelnen Dienst. Ein Proxy bündelt diese Aufgaben in einer Schicht, die Sie steuern können.
Was ist ein LLM-Proxy?
Ein LLM-Proxy ist ein API-Gateway für Modell-Traffic. Das Projekt LiteLLM beschreibt seinen Proxy als selbst gehosteten Server mit "one OpenAI-compatible endpoint for 100+ LLM providers", also einem OpenAI-kompatiblen Endpunkt für mehr als 100 Anbieter. Bestehender Code für OpenAI-Clients kann ohne Änderungen darauf zeigen.
Der Proxy übernimmt Routing, Autorisierung, Logging und Kostenerfassung, bevor er die Anfrage weiterleitet. Für Ihre Dienste wirkt er wie eine einzige, stabile API. Für die Anbieter wirkt er wie ein normaler API-Client.
Es gibt auch verwaltete Optionen. Cloudflares AI Gateway ist ein gehosteter Dienst, der KI-Anwendungen um Analysen, Logging, Caching, Ratenbegrenzung sowie Retry und Fallback ergänzt.
LLM-Proxy im Vergleich zu direkten API-Aufrufen
Die Tabelle vergleicht beide Varianten anhand der Aufgaben, die in der Produktion zählen. Der Funktionsumfang unterscheidet sich je nach Produkt. Prüfen Sie deshalb die Dokumentation Ihres Tools.
| Aspekt | Direkte Anbieter-API-Aufrufe | Über einen LLM-Proxy |
|---|---|---|
| Retries und Fallback | In jedem Dienst selbst geschrieben und gepflegt | Einmal konfiguriert; LiteLLM unterstützt zum Beispiel num_retries und geordnete fallbacks |
| Kostenerfassung | Eigenes Dashboard je Anbieter | Kosten pro Schlüssel, Team, Nutzer oder Tag an einer Stelle erfasst |
| Ratenlimits | Nur die Limits des Anbieters | Eigene Limits pro Schlüssel, etwa Anfragen oder Tokens pro Minute |
| Schlüsselverwaltung | Anbieterschlüssel in Repos und auf Rechnern verteilt | Virtuelle Schlüssel für Dienste; Anbieterschlüssel bleiben im Proxy |
| Logging | Was jeder Dienst selbst protokolliert | Zentrale Anfrage- und Fehlerprotokolle, oft exportierbar zu Tools wie Langfuse oder Datadog |
| Anbieterwechsel | Codeänderungen in jedem Dienst | Zuordnung im Proxy ändern |
| Betriebsaufwand | Kein zusätzlicher | Eine weitere Komponente, die Sie betreiben, absichern und verfügbar halten müssen |
Warum Anbieter-Dashboards nicht ausreichen
Anbieter-Dashboards zeigen, was ein Konto bei einem Anbieter ausgegeben hat. Sie sind nicht auf Ihre interne Struktur zugeschnitten. Wer Nutzung nach internem Mandanten, Funktion oder Umgebung aufschlüsseln will, muss Anfragen meist selbst markieren.
Nutzen Sie mehrere Anbieter, vergleichen Sie zudem Daten aus mehreren Portalen mit unterschiedlichen Formaten. Ein Proxy erfasst jede Anfrage im selben Schema, sodass Sie nach den Feldern filtern können, die für Sie zählen.
Welche Probleme löst ein LLM-Proxy?
Zentrale Schlüsselverwaltung und Sicherheit
Wenn Sie Anbieterschlüssel über Repos und Entwicklerrechner verteilen, vergrößern Sie Ihre Angriffsfläche. Mit einem Proxy geben Sie stattdessen virtuelle Schlüssel an Dienste und Entwickler aus.
Laut der LiteLLM-Dokumentation lassen sich virtuelle Schlüssel auf bestimmte Modelle beschränken, mit Budgets und Ratenlimits versehen, sperren und mit Ablaufdatum ausstatten. Die Hauptschlüssel der Anbieter bleiben in der Proxy-Umgebung.
Kostenerfassung und Ratenlimits
Ein Proxy kann die Kosten jeder Anfrage erfassen und einem Schlüssel, Nutzer, Team oder Tag zuordnen. Dann können Sie pro Schlüssel ein max_budget setzen und Anfragen oder Tokens pro Minute begrenzen.
So fangen Sie eine außer Kontrolle geratene Agenten-Schleife über eine Budgetgrenze ab, statt von einer überraschenden Rechnung überrascht zu werden. Was der Anbieter berechnet, ändert sich dadurch nicht.
Retries und Fallbacks über mehrere Anbieter
Modell-APIs laufen in Ratenlimits und Fehler. Ohne Proxy braucht jeder Dienst eigenen Retry- und Failover-Code.
In LiteLLM legen Sie zuerst die Zahl der Retries fest, danach eine geordnete Liste von Fallback-Modellen. Schlägt ein Aufruf nach seinen Retries fehl, probiert der Proxy die nächste Modellgruppe. Auch Cloudflare AI Gateway nennt Retry und Fallback unter seinen Funktionen.
[Anwendungscode]
       |
       v
[LLM-Proxy]
       |-- Primär: Modell von Anbieter A
       '-- Fallback: Modell von Anbieter B
Profi-Tipp: Fallback-Modelle können sich in Qualität, Kontextgröße und Preis unterscheiden. Testen Sie den Fallback-Pfad mit Ihren echten Prompts, bevor Sie sich darauf verlassen.
Logging und ein stabiler Endpunkt
Zentrale Logs zeigen Ihnen Nutzlast, Latenz und Fehler jeder Anfrage. Seien Sie hier vorsichtig: Prompts enthalten oft personenbezogene oder vertrauliche Daten. Legen Sie daher fest, was Sie wie lange speichern.
Ein stabiler Endpunkt hilft auch bei Veränderungen. Modelle und Versionen wechseln schnell. Mit einem Proxy ändern Sie die Modellzuordnung an einer Stelle, statt jeden Microservice anzupassen.
Wie führen Sie einen LLM-Proxy ein?
Sie müssen kein Gateway von Grund auf bauen. Starten Sie mit einem vorhandenen Tool und testen Sie es im Staging.
- Tool wählen: Vergleichen Sie eine selbst gehostete Option wie LiteLLM mit einem verwalteten Gateway wie Cloudflare AI Gateway.
- Bereitstellen: Betreiben Sie es beim Selbst-Hosting in Ihrer eigenen Cloud oder VPC, etwa mit Docker oder Kubernetes.
- Anbieterschlüssel verschieben: Legen Sie sie in der Proxy-Umgebung ab, nicht in App-Repos.
- Virtuelle Schlüssel ausgeben: Erstellen Sie je einen pro Dienst oder Umgebung, mit Budgets und Modellbeschränkungen.
- Basis-URL ändern: Richten Sie Ihr SDK oder Ihren HTTP-Client auf den Proxy statt auf den Anbieter.
- Logging aktivieren: Senden Sie Logs und Metriken an den Monitoring-Stack, den Sie bereits nutzen.
Abwägungen
Ein Proxy ist auch eine neue Fehlerquelle. Fällt er aus, fallen alle KI-Aufrufe mit aus. Planen Sie deshalb Hochverfügbarkeit ein. Er fügt einen Netzwerksprung hinzu, und ein selbst gehosteter Proxy verlangt Patches und Sicherheitsarbeit.
Für eine einzelne kleine App mit einem Anbieter reichen direkte Aufrufe womöglich aus. Ein Proxy lohnt sich, wenn Dienste, Anbieter und Nutzer zunehmen. Wenn Kosten Ihr Hauptthema sind, lesen Sie zuerst unseren Leitfaden zum Berechnen der Token-Kosten für ein KI-Projekt.
Quellen
- LiteLLM AI Gateway (Proxy), Dokumentation
- LiteLLM: Virtuelle Schlüssel
- LiteLLM: Zuverlässigkeit, Retries und Fallbacks
- Cloudflare AI Gateway, Dokumentation